ファイルストレージの連携
このページでは、クラウドデータ取り込みを設定し、Amazon S3、Google Cloud Storage、またはAzure Blob StorageからBrazeにデータを同期する方法について説明します。
仕組み
Cloud Data Ingestion (CDI) を使用すると、クラウドアカウント内の1つ以上のストレージバケットをBrazeと直接統合できます。バケットに新しいファイルが追加されると、クラウドプロバイダーが通知を発行し、Braze Cloud Data Ingestionがデータを同期します。
通知メカニズムはプロバイダーによって異なります。
- Amazon S3: 新しいファイルがS3に公開されると、Amazon Simple Queue Service (SQS) キューにメッセージが送信され、Brazeがそのメッセージを消費して新しいファイルを取り込みます。
- Google Cloud Storage (GCS): バケット内で新しいファイルがファイナライズされると、GCSが
OBJECT_FINALIZE通知をPub/Subトピックに発行します。BrazeはPub/Subサブスクリプションからこれらの通知を消費して、新しいファイルを取り込みます。 - Azure Blob Storage: コンテナ内に新しいファイルが作成されると、Azure Event GridのイベントサブスクリプションがBlob CreatedイベントをAzure Storageキューに発行します。Brazeはキューからこれらのメッセージを読み取り、新しいファイルを取り込みます。
Cloud Data Ingestionは以下をサポートしています。
- JSONファイル
- CSVファイル
- Parquetファイル
- 属性、カスタムイベント、購入イベント、ユーザー削除、およびカタログデータ
クラウドデータ取り込みの設定
設定手順はファイルストレージプロバイダーによって異なります。プロバイダーのタブを選択し、その後のセクションで共通の設定を完了してください。
この連携には以下のリソースが必要です。
- データストレージ用のS3バケット
- 新しいファイル通知用のSQSキュー
- Brazeアクセス用のIAMロール
AWSの定義
| 用語 | 定義 |
|---|---|
| Amazon Resource Name (ARN) | ARNはAWSリソースの一意の識別子です。 |
| Identity and Access Management (IAM) | IAMはAWSリソースへのアクセスをセキュアに制御できるWebサービスです。このチュートリアルでは、IAMポリシーを作成し、IAMロールに割り当てて、S3バケットをBrazeクラウドデータ取り込みと連携させます。 |
| Amazon Simple Queue Service (SQS) | SQSは、分散ソフトウェアシステムやコンポーネントを統合できるホステッドキューです。 |
AWSでのクラウドデータ取り込みの設定
ステップ1:ソースバケットを作成する
AWSアカウントでデフォルト設定の汎用S3バケットを作成します。S3バケットはフォルダが一意であれば、複数の同期で再利用できます。
デフォルト設定は以下のとおりです。
- ACL無効
- パブリックアクセスをすべてブロック
- バケットのバージョニングを無効化
- SSE-S3暗号化
- SSE-S3は唯一サポートされているサーバーサイド暗号化タイプです。Amazon KMS暗号化はサポートされていません。
バケットを作成したリージョンをメモしてください。次のステップで同じリージョンにSQSキューを作成します。
ステップ2:SQSキューを作成する
作成したバケットにオブジェクトが追加されたことを追跡するためのSQSキューを作成します。現時点ではデフォルトの設定を使用してください。
SQSキューはグローバルに一意である必要があります(たとえば、1つのCDI同期にのみ使用でき、別のワークスペースで再利用することはできません)。
SQSはバケットを作成したリージョンと同じリージョンに作成してください。
SQSキューのARNとURLをメモしてください。この設定中に頻繁に必要になります。
ステップ3:アクセスポリシーを設定する
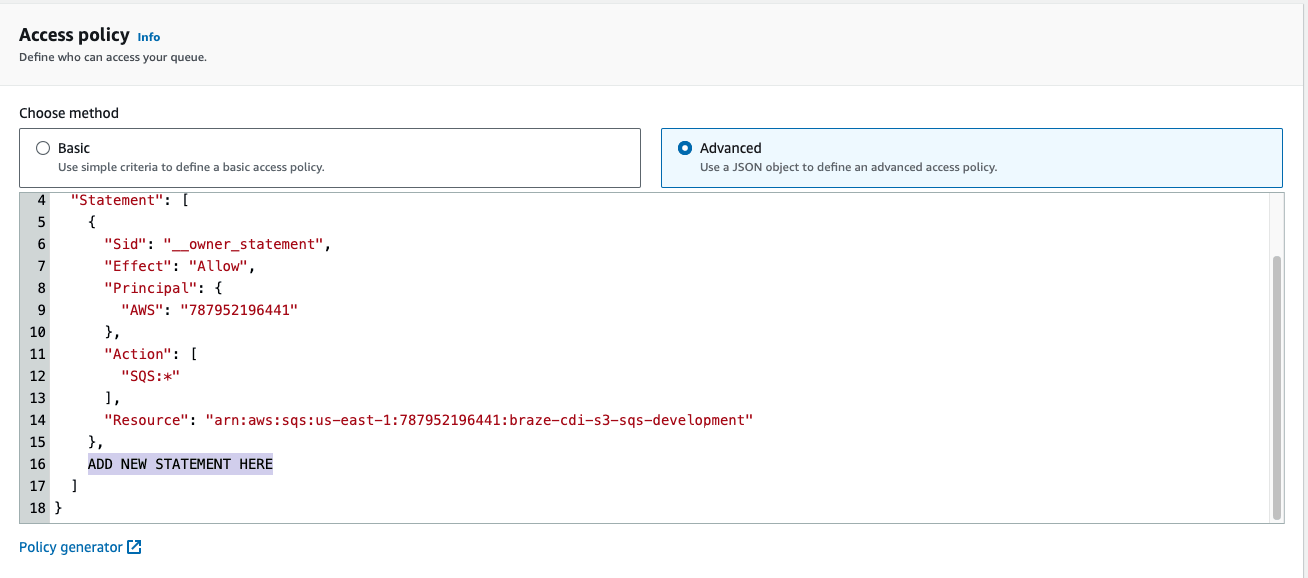
アクセスポリシーを設定するには、Advanced optionsを選択します。
以下のステートメントをキューのアクセスポリシーに追加します。YOUR-BUCKET-NAME-HEREをバケット名に、YOUR-SQS-ARNをSQSキューのARNに、YOUR-AWS-ACCOUNT-IDをAWSアカウントIDにそれぞれ置き換えてください。
{
"Sid": "braze-cdi-s3-sqs-publish",
"Effect": "Allow",
"Principal": {
"Service": "s3.amazonaws.com"
},
"Action": "SQS:SendMessage",
"Resource": "YOUR-SQS-ARN",
"Condition": {
"StringEquals": {
"aws:SourceAccount": "YOUR-AWS-ACCOUNT-ID"
},
"ArnLike": {
"aws:SourceArn": "arn:aws:s3:::YOUR-BUCKET-NAME-HERE"
}
}
}
ステップ4:S3バケットにイベント通知を追加する
- ステップ1で作成したバケットで、Properties > Event notificationsに移動します。
- 設定に名前を付けます。Brazeに取り込むファイルのサブセットのみを対象にしたい場合は、オプションでプレフィックスまたはサフィックスを指定します。
- DestinationでSQS queueを選択し、ステップ2で作成したSQSのARNを入力します。
S3バケットのルートフォルダにファイルをアップロードしてから、一部のファイルをバケット内の特定のフォルダに移動すると、予期しないエラーが発生する場合があります。代わりに、プレフィックス内のファイルのみに対してイベント通知を送信するように変更するか、そのプレフィックス外にS3バケットにファイルを配置しないようにするか、プレフィックスなしで連携を更新してすべてのファイルを取り込むようにしてください。
ステップ5:IAMポリシーを作成する
Brazeがソースバケットとやり取りできるようにするためのIAMポリシーを作成します。開始するには、アカウント管理者としてAWS管理コンソールにサインインします。
-
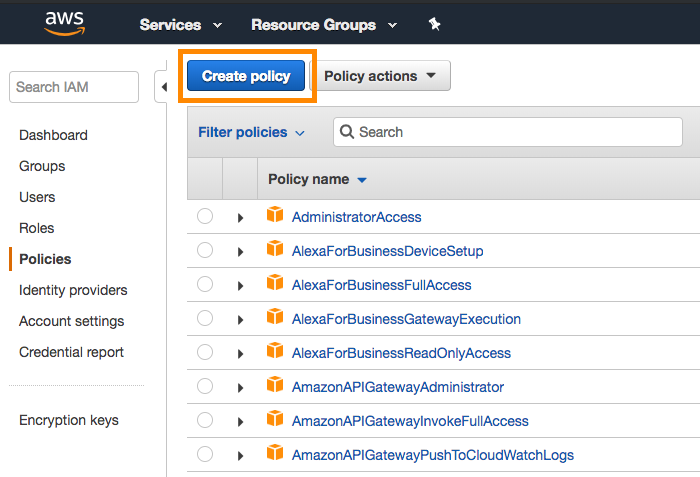
AWSコンソールのIAMセクションに移動し、ナビゲーションバーでPoliciesを選択してから、Create Policyを選択します。
-
JSONタブを開き、以下のコードスニペットをPolicy Documentセクションに入力します。
YOUR-BUCKET-NAME-HEREをバケット名に、YOUR-SQS-ARN-HEREをSQSキュー名にそれぞれ置き換えてください。
{
"Version": "2012-10-17",
"Statement": [
{
"Effect": "Allow",
"Action": ["s3:ListBucket", "s3:GetObjectAttributes", "s3:GetObject"],
"Resource": ["arn:aws:s3:::YOUR-BUCKET-NAME-HERE"]
},
{
"Effect": "Allow",
"Action": ["s3:ListBucket", "s3:GetObjectAttributes", "s3:GetObject"],
"Resource": ["arn:aws:s3:::YOUR-BUCKET-NAME-HERE/*"]
},
{
"Effect": "Allow",
"Action": [
"sqs:DeleteMessage",
"sqs:GetQueueUrl",
"sqs:ReceiveMessage",
"sqs:GetQueueAttributes"
],
"Resource": "YOUR-SQS-ARN-HERE"
}
]
}
-
完了したらReview Policyを選択します。
-
ポリシーに名前と説明を付けてから、Create Policyを選択します。
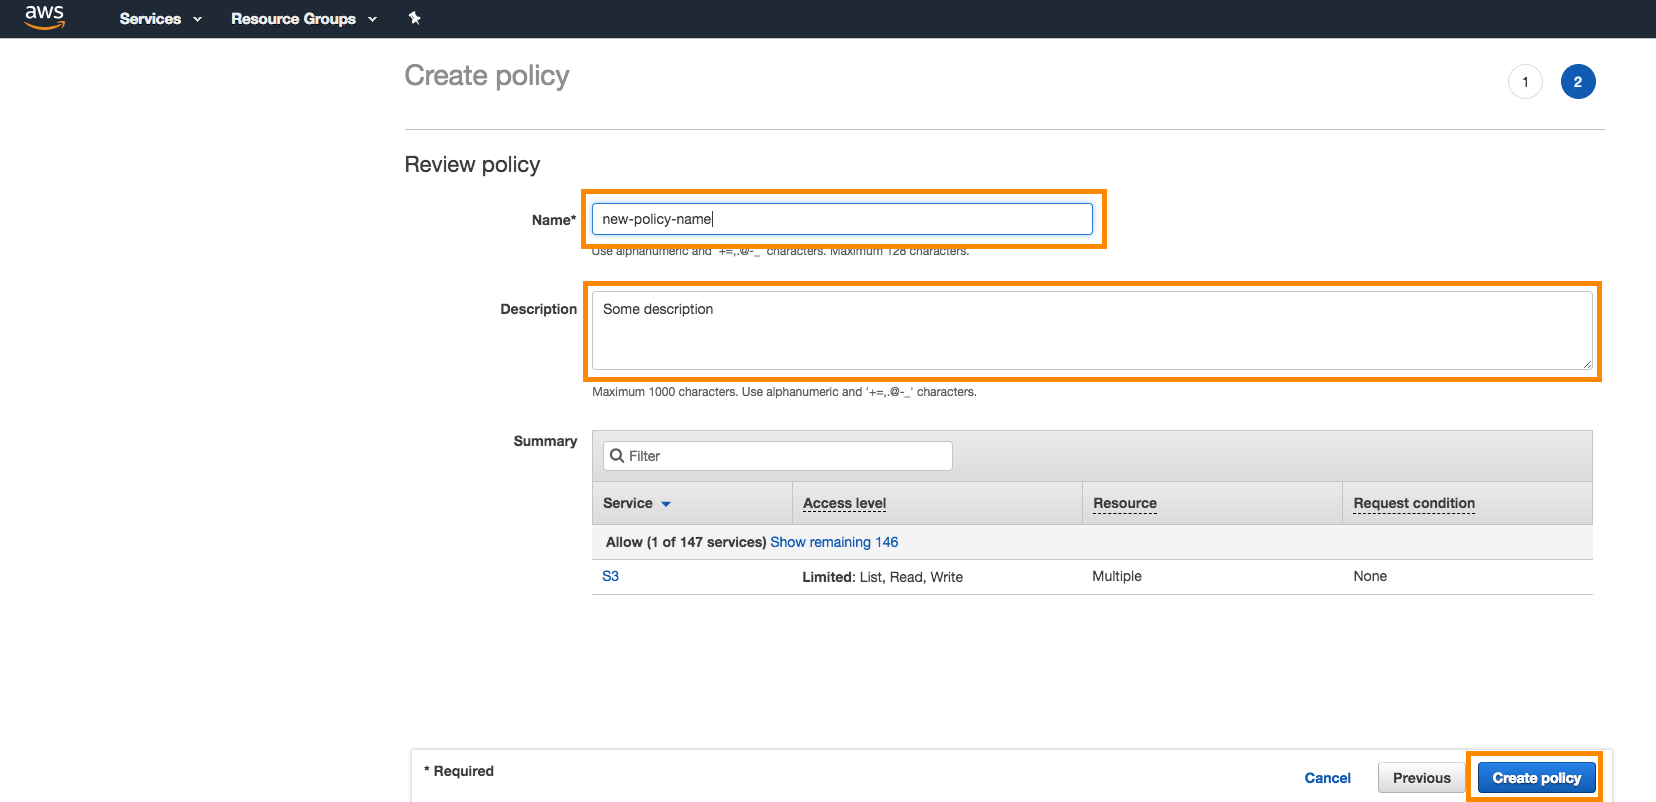
ステップ6:IAMロールを作成する
AWSでの設定を完了するには、IAMロールを作成し、ステップ5のIAMポリシーをアタッチします。
- IAMポリシーを作成したコンソールの同じIAMセクションで、Roles > Create Roleに移動します。
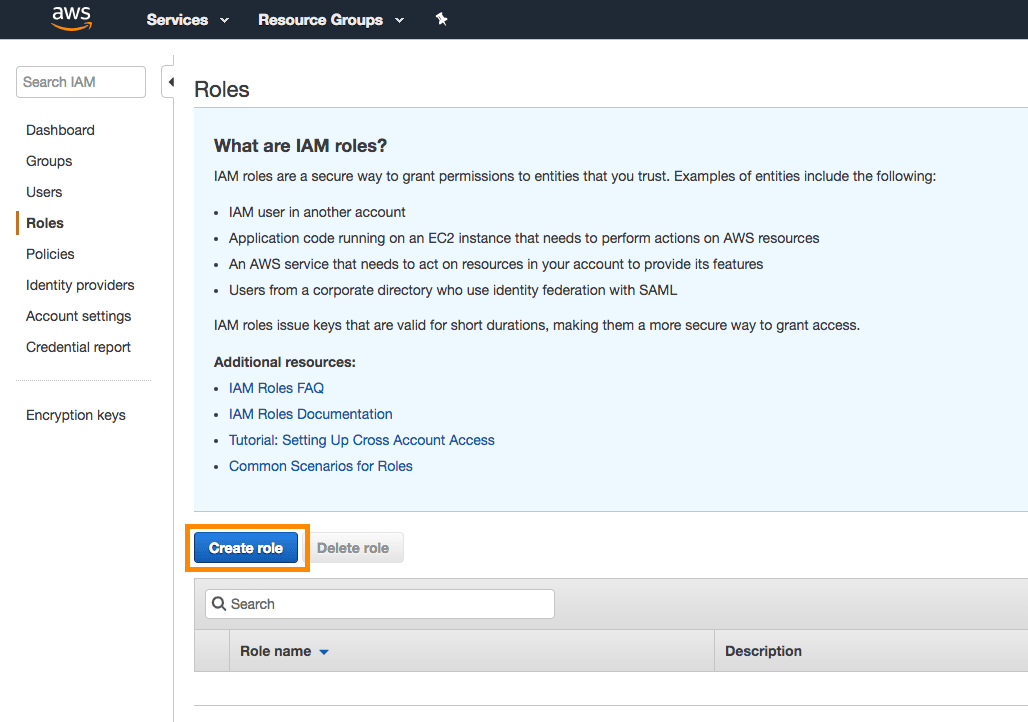
- AWSで、信頼されたエンティティセレクタータイプとしてAnother AWS Accountを選択します。BrazeアカウントIDを入力します。Require external IDチェックボックスを選択します。
- Brazeで、Data Settings > Cloud Data Ingestion > Sourcesに移動し、Add data sourceを選択してから、ファイルソースセクションでAmazon S3を選択します。
- 自動生成されたBraze Account IDをコピーします。
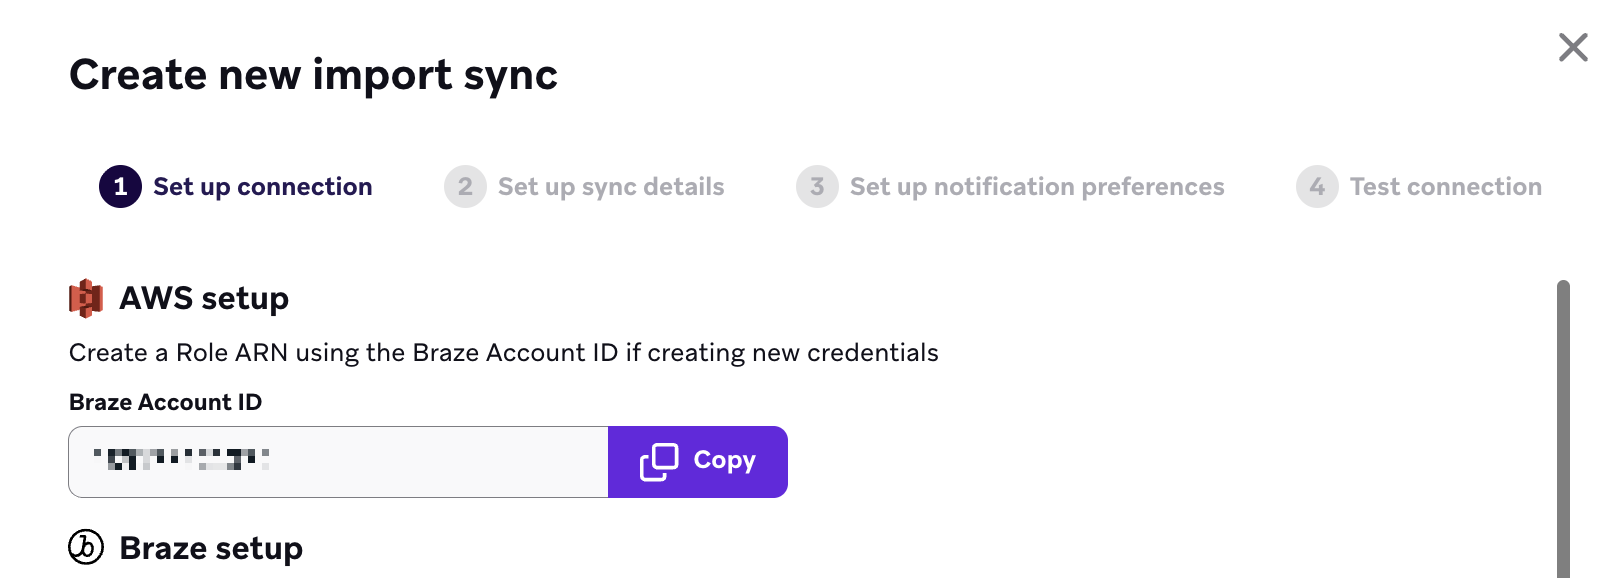
- AWSでアカウントIDを貼り付けてから、Nextを選択します。
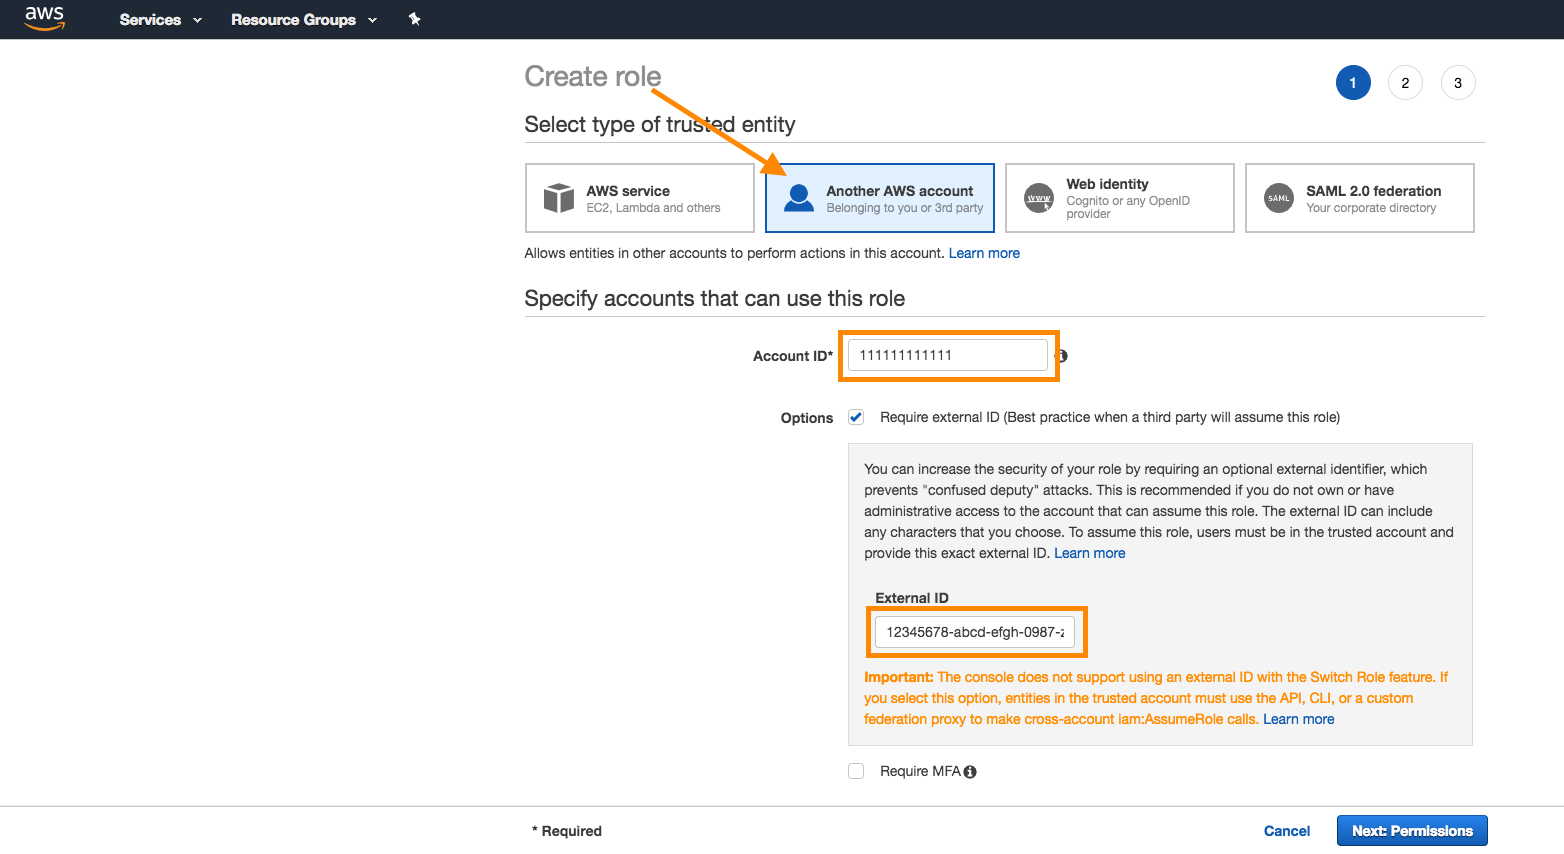
- ステップ4で作成したポリシーをロールにアタッチします。検索バーでポリシーを検索し、ポリシーの横にあるチェックマークを選択してアタッチします。完了したらNextを選択します。
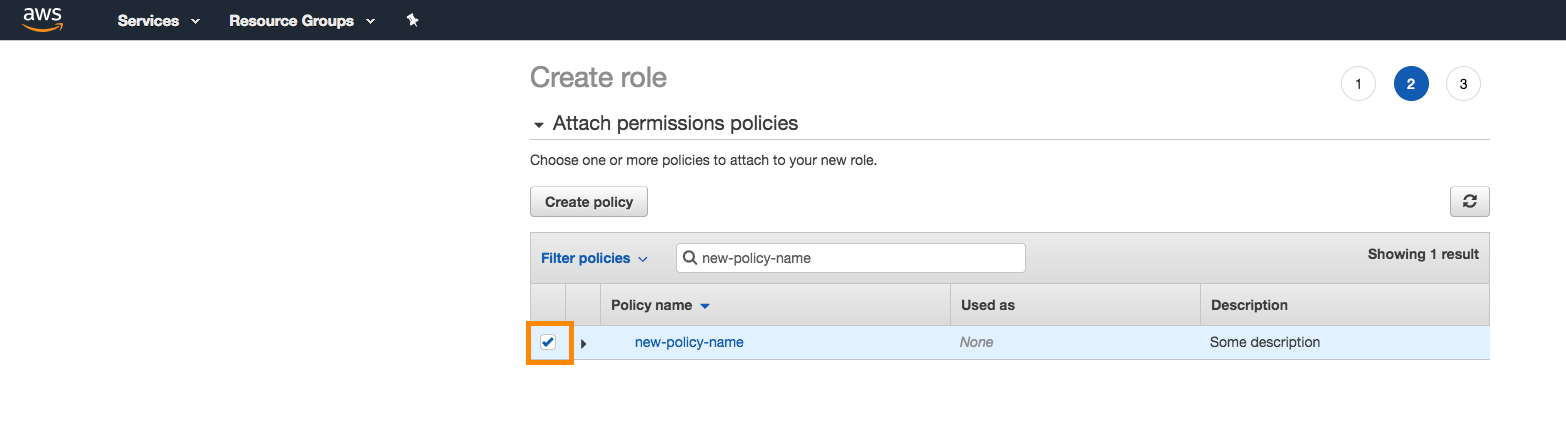
ロールに名前と説明を付けてから、Create Roleを選択します。
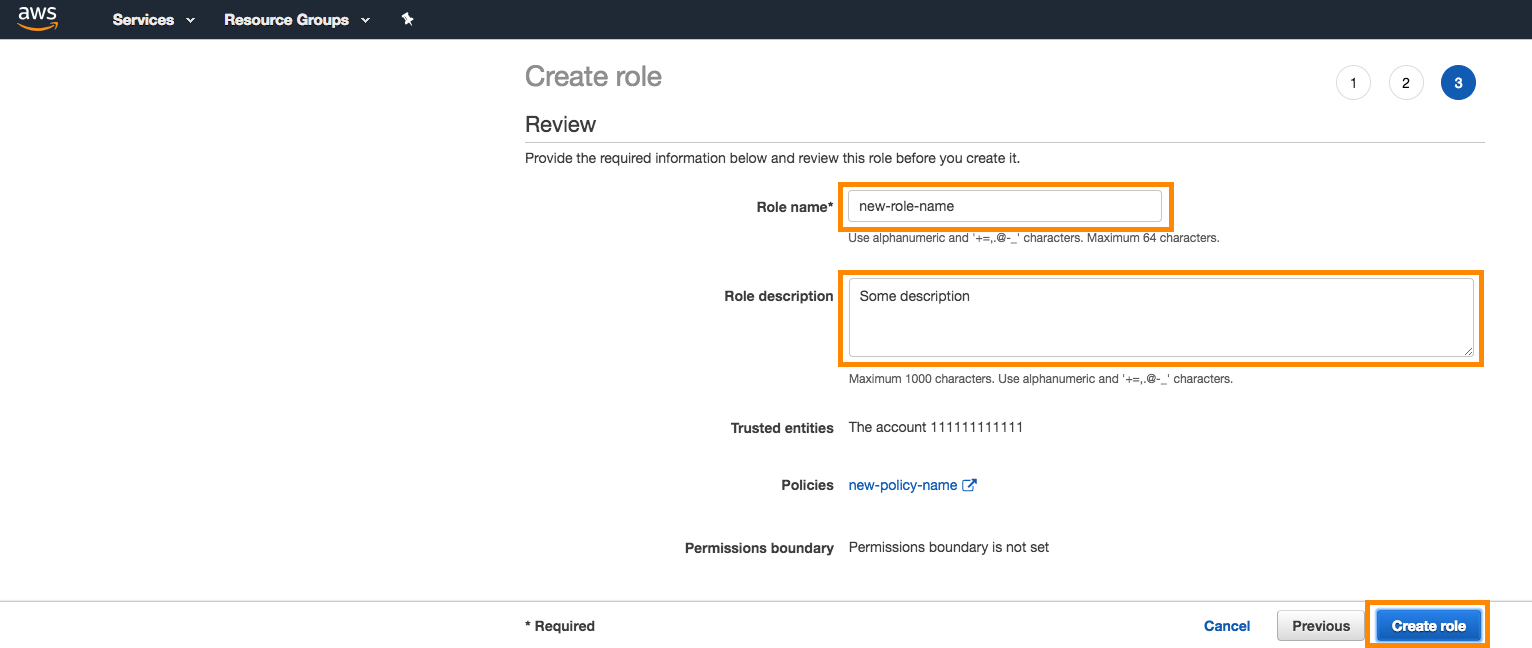
- 作成したロールのARNと生成した外部IDをメモしてください。クラウドデータ取り込み連携の作成に必要になります。
Brazeでのクラウドデータ取り込みの設定
- まず、Brazeダッシュボードで新しいソースを作成します。Data Settings > Cloud Data Ingestion > Sourcesに移動し、Add data sourceを選択してから、Amazon S3を選択します。
- ソースの名前を選択し、AWSの設定プロセスで取得した情報を入力して新しいソースを作成します。以下を指定してください。
- ロールARN
- 外部ID
- バケット名
- リージョン
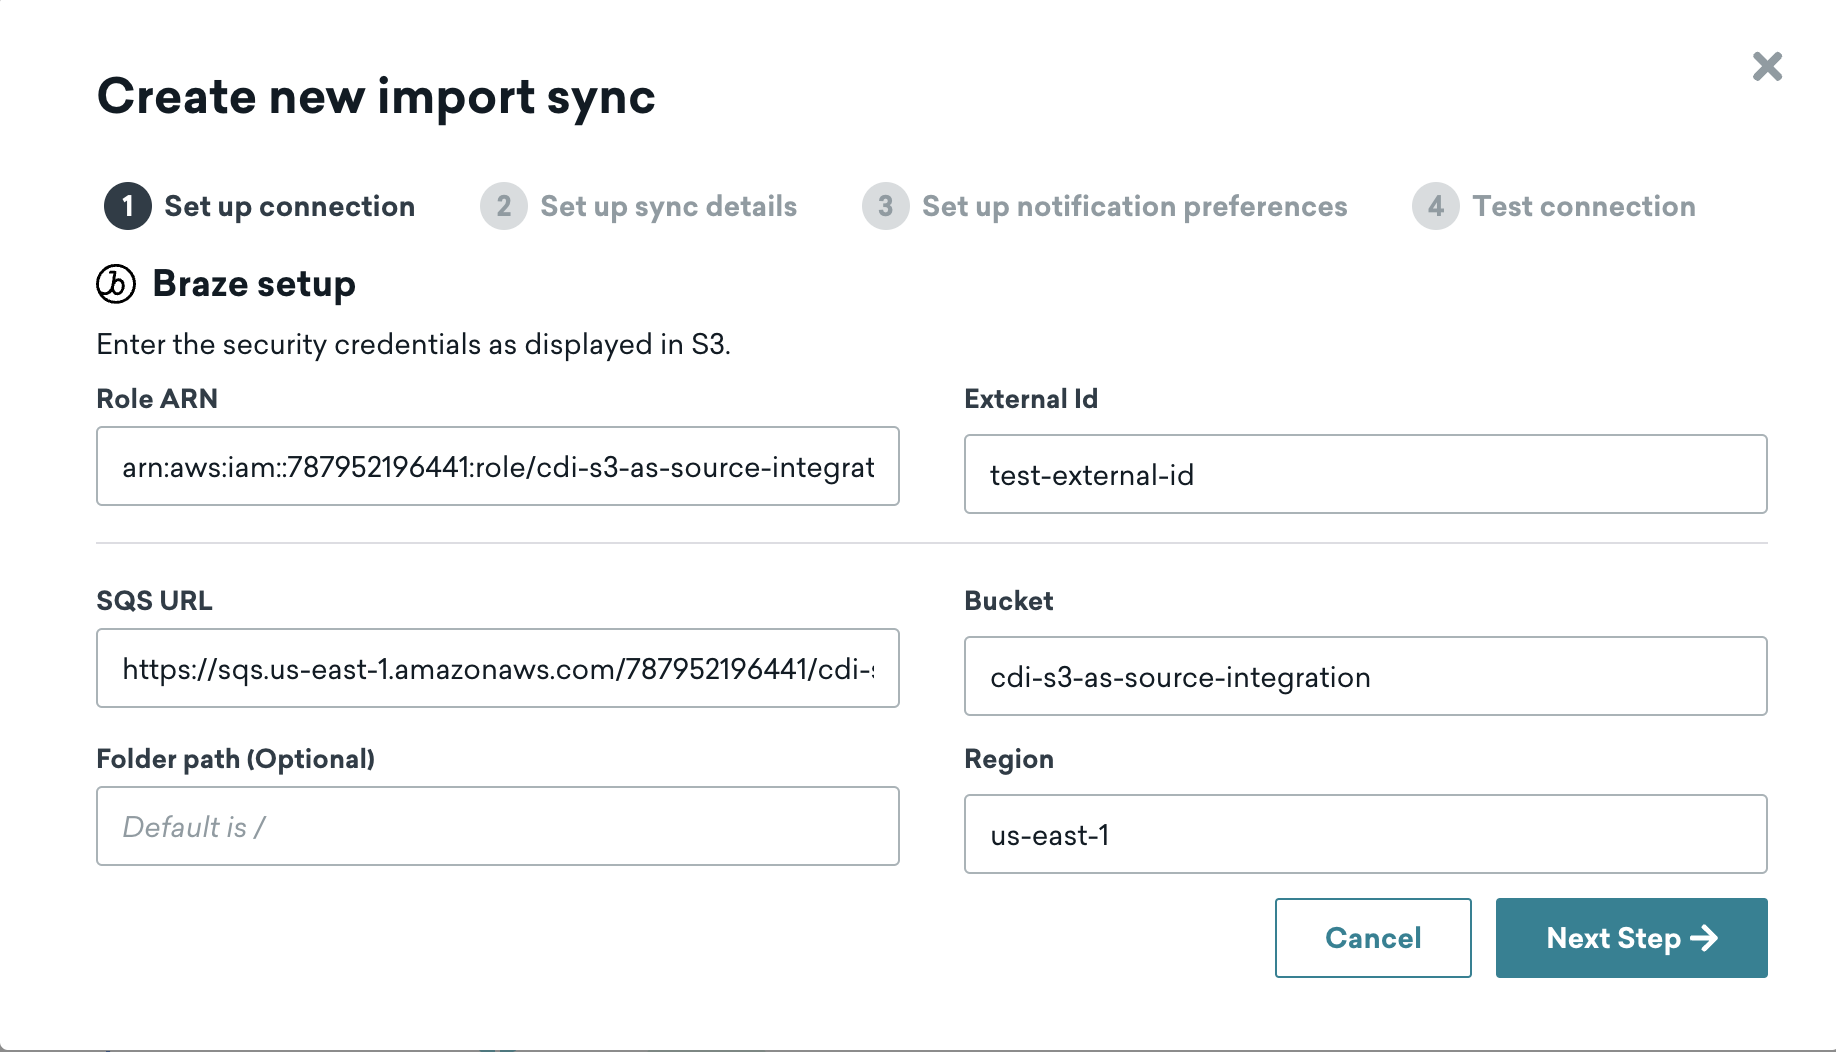
- Test connectionを選択して、Brazeがバケットにアクセスできることを確認します。テストが成功したら、Connect to Sourceを選択します。接続に失敗した場合は、問題のトラブルシューティングに役立つエラーメッセージが表示されます。
- 次に、新しい同期を作成します。Data Settings > Cloud Data Ingestion > Syncsに移動し、Create data syncを選択します。
- 同期の名前を選択します。次に、アクティブなS3ソースを選択し、同期のソーステーブルを入力します。データタイプを選択し、Test Connectionを選択します。
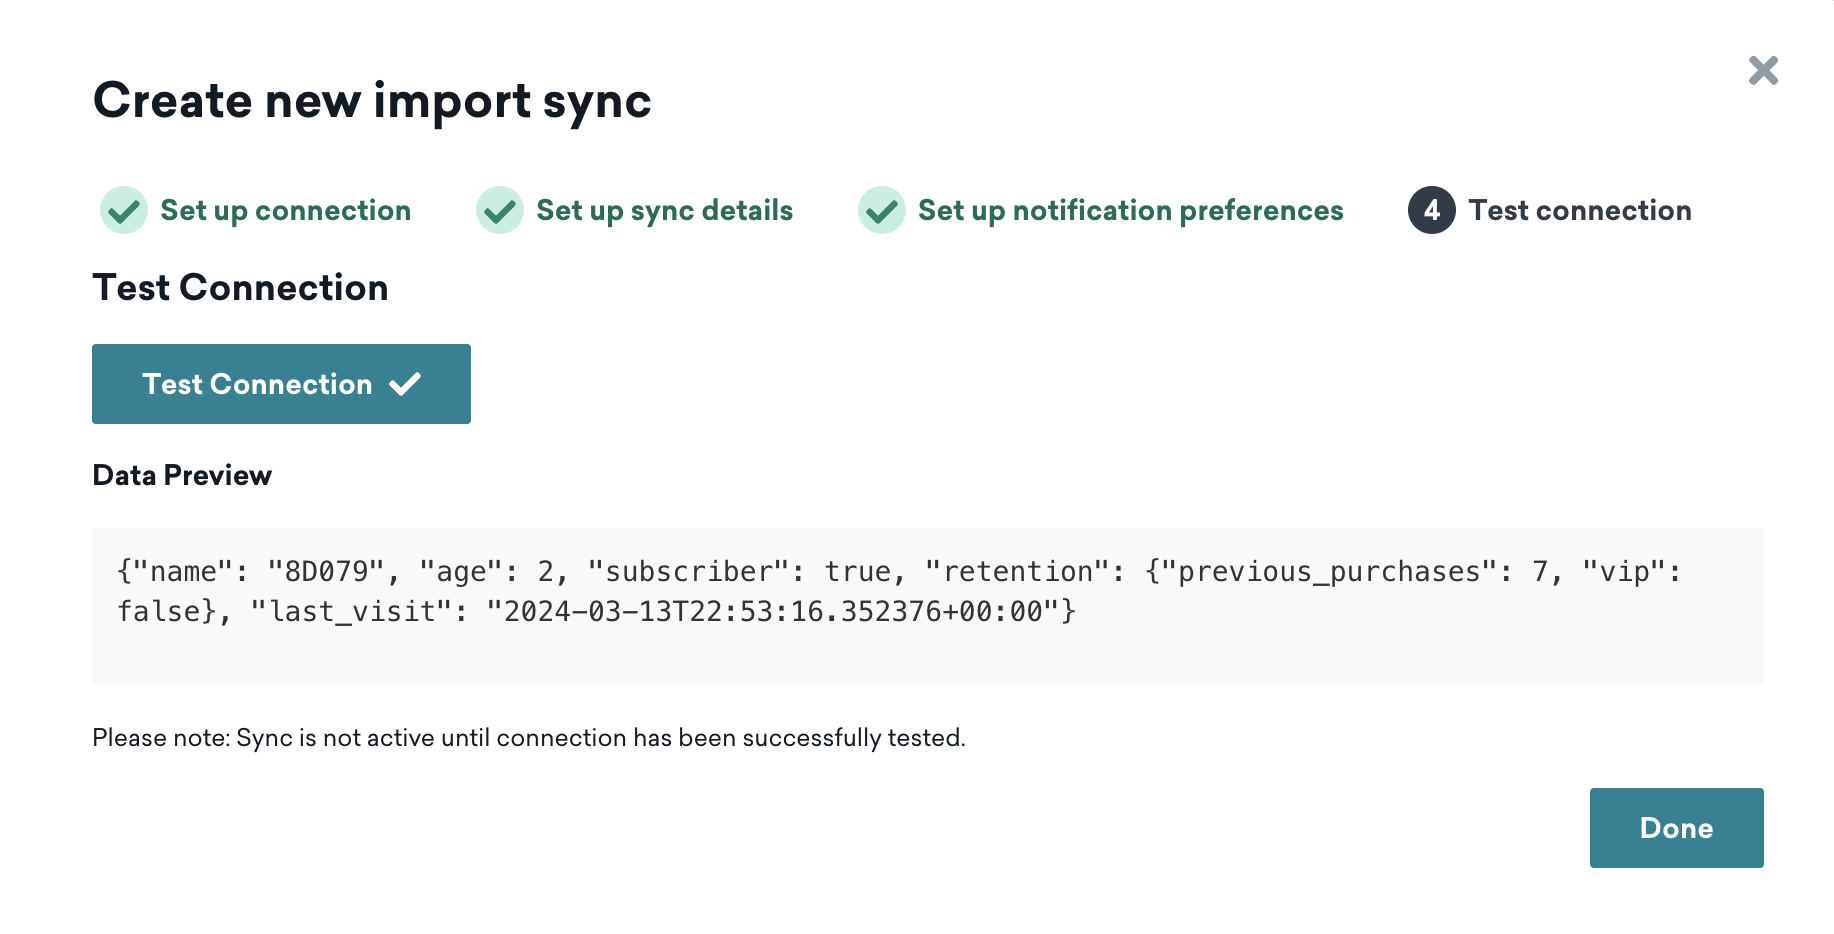
- AWSの設定プロセスで取得した残りの情報を入力します。以下を指定してください。
- SQS URL(新しい連携ごとに一意である必要があります)
- フォルダパス(オプション、ワークスペース内の同期間で一意である必要があります)
- データタイプを選択し、Test Connectionを選択して、Brazeが取り込み可能なファイルを一覧表示できることを確認します(ファイル内のデータではありません)。成功したら、Next: Notificationsを選択します。
- アクセスや権限の問題で同期が中断された場合の通知用に、連絡先メールアドレスを追加します。オプションで、ユーザーレベルのエラーや同期成功の通知を有効にできます。
- 同期を作成します。
この連携には以下のリソースが必要です。
- データストレージ用のCloud Storageバケット
- 新しいファイル通知用のPub/Subトピックとサブスクリプション
- JSONキーをBrazeにアップロードするサービスアカウント
GCPの定義
| 用語 | 定義 |
|---|---|
| Google Cloudプロジェクト | プロジェクトはすべてのGoogle Cloudリソースを整理するもので、一意のプロジェクトIDとプロジェクト番号で識別されます。 |
| Cloud Storageバケット | バケットは、Brazeに取り込むデータファイルを保持するコンテナです。 |
| Pub/Subトピック | トピックは、Cloud Storageバケットから新しいファイルの通知を受け取る名前付きリソースです。 |
| Pub/Subサブスクリプション | サブスクリプションはトピックにアタッチされ、メッセージを配信します。Brazeはプルサブスクリプションから新しいファイルの通知を受け取ります。 |
| サービスアカウント | サービスアカウントは、Brazeがバケットとサブスクリプションにアクセスするために使用する非人間IDです。JSONキーをBrazeにアップロードします。 |
| IAMロール | Identity and Access Management (IAM) ロールは、バケットとサブスクリプションのサービスアカウントに割り当てる権限の集合です。 |
Google Cloudでのクラウドデータ取り込みの設定
ステップ1:Cloud Storageバケットを作成する
Google Cloudコンソールで、Cloud Storage > Buckets > Createに移動します。プロジェクトIDとバケット名をメモしてください。Brazeでソースを設定する際に必要になります。権限をIAMで管理できるように、均一なバケットレベルアクセスを有効にすることをお勧めします。
または、gcloudでバケットを作成します。
gcloud storage buckets create gs://YOUR-BUCKET-NAME \
--project=YOUR-PROJECT-ID \
--location=YOUR-REGION \
--uniform-bucket-level-access
ステップ2:Pub/Subトピックとサブスクリプションを作成する
Google Cloudコンソールで、Pub/Sub > Topics > Create topicに移動します。Googleにデフォルトのサブスクリプションを作成させるか、別途作成できます。次に、そのトピックにプルサブスクリプションを作成します。
または、gcloudを使用します。
gcloud pubsub topics create YOUR-TOPIC --project=YOUR-PROJECT-ID
gcloud pubsub subscriptions create YOUR-SUBSCRIPTION \
--topic=YOUR-TOPIC --project=YOUR-PROJECT-ID --ack-deadline=60
サブスクリプションIDをメモしてください。同期を作成する際にBrazeが必要とするのはサブスクリプション(トピックではなく)です。サブスクリプションはプルサブスクリプションである必要があります。
このサブスクリプションにデッドレターキューを設定しないでください。Brazeはクラウドデータ取り込みサブスクリプションのデッドレターキューをサポートしていません。詳しくは、Google Cloudドキュメントのデッドレタートピックを参照してください。
ステップ3:バケット通知をトピックに送信する
Cloud StorageからPub/Subへの通知の作成は、Google Cloudコンソールでは利用できません。gcloud(ここで示す方法)、Terraform、またはJSON APIを使用する必要があります。詳しくは、Google CloudドキュメントのCloud StorageのPub/Sub通知を設定するを参照してください。
まず、Cloud Storageサービスエージェントにトピックへのパブリッシュ権限を割り当ててから、OBJECT_FINALIZEの通知を作成します。OBJECT_FINALIZEイベントは、バケットに新しいオブジェクトが作成またはファイナライズされるたびに発火します。
# Get the Cloud Storage service agent for your project
gcloud storage service-agent --project=YOUR-PROJECT-ID
# Assign it Pub/Sub Publisher on the topic
gcloud pubsub topics add-iam-policy-binding YOUR-TOPIC \
--project=YOUR-PROJECT-ID \
--member="serviceAccount:service-YOUR-PROJECT-NUMBER@gs-project-accounts.iam.gserviceaccount.com" \
--role="roles/pubsub.publisher"
# Create the OBJECT_FINALIZE notification (optionally scope to a folder with --object-prefix)
gcloud storage buckets notifications create gs://YOUR-BUCKET-NAME \
--topic=YOUR-TOPIC \
--event-types=OBJECT_FINALIZE \
--payload-format=json
これらのコマンドで以下のプレースホルダーを置き換えてください。
YOUR-PROJECT-ID: Google CloudプロジェクトID、人間が読める識別子(例:my-gcp-project)。YOUR-TOPIC: ステップ2で作成したPub/Subトピック。YOUR-BUCKET-NAME: Cloud Storageバケット名。YOUR-PROJECT-NUMBER: プロジェクト番号、Cloud Storageサービスエージェントのメールアドレスで使用される数値の識別子。これはプロジェクトIDとは異なります。Google CloudコンソールのDashboardで確認するか、以下のコマンドを実行してください。
gcloud projects describe YOUR-PROJECT-ID --format="value(projectNumber)"
ステップ4:サービスアカウントを作成する
Google Cloudコンソールで、IAM & Admin > Service Accounts > Create service accountに移動します。
または、gcloudを使用します。
gcloud iam service-accounts create braze-cdi-gcs \
--project=YOUR-PROJECT-ID \
--display-name="Braze CDI GCS"
ステップ5:権限を割り当てる
コネクタが必要とする権限は、バケットに対するstorage.buckets.get、storage.objects.get、storage.objects.listと、サブスクリプションに対するpubsub.subscriptions.consumeのみです。カスタムロールまたは事前定義ロールで割り当てることができます。
カスタムロール: それらの権限のみを持つカスタムロールを作成し、バケットとサブスクリプションにバインドします。
gcloud iam roles create brazeCdiGcs --project=YOUR-PROJECT-ID \
--title="Braze CDI GCS" \
--permissions=storage.buckets.get,storage.objects.get,storage.objects.list,pubsub.subscriptions.consume \
--stage=GA
gcloud storage buckets add-iam-policy-binding gs://YOUR-BUCKET-NAME \
--member="serviceAccount:braze-cdi-gcs@YOUR-PROJECT-ID.iam.gserviceaccount.com" \
--role="projects/YOUR-PROJECT-ID/roles/brazeCdiGcs"
gcloud pubsub subscriptions add-iam-policy-binding YOUR-SUBSCRIPTION \
--project=YOUR-PROJECT-ID \
--member="serviceAccount:braze-cdi-gcs@YOUR-PROJECT-ID.iam.gserviceaccount.com" \
--role="projects/YOUR-PROJECT-ID/roles/brazeCdiGcs"
事前定義ロール: バケットにroles/storage.objectViewerとroles/storage.legacyBucketReaderを、サブスクリプションにroles/pubsub.subscriberを割り当てます。objectViewerロールはstorage.objects.getとstorage.objects.listを提供し、legacyBucketReaderはstorage.buckets.getを提供します。
gcloud storage buckets add-iam-policy-binding gs://YOUR-BUCKET-NAME \
--member="serviceAccount:braze-cdi-gcs@YOUR-PROJECT-ID.iam.gserviceaccount.com" \
--role="roles/storage.objectViewer"
gcloud storage buckets add-iam-policy-binding gs://YOUR-BUCKET-NAME \
--member="serviceAccount:braze-cdi-gcs@YOUR-PROJECT-ID.iam.gserviceaccount.com" \
--role="roles/storage.legacyBucketReader"
gcloud pubsub subscriptions add-iam-policy-binding YOUR-SUBSCRIPTION \
--project=YOUR-PROJECT-ID \
--member="serviceAccount:braze-cdi-gcs@YOUR-PROJECT-ID.iam.gserviceaccount.com" \
--role="roles/pubsub.subscriber"
ステップ6:JSONキーを作成する
Google Cloudコンソールでサービスアカウントを開き、Keys > Add key > Create new keyに移動して、JSONを選択します。
または、gcloudを使用します。
gcloud iam service-accounts keys create braze-cdi-gcs-key.json \
--iam-account=braze-cdi-gcs@YOUR-PROJECT-ID.iam.gserviceaccount.com
Brazeでのクラウドデータ取り込みの設定
- Brazeで、Data Settings > Cloud Data Ingestion > Sourcesに移動し、Add data sourceを選択してから、Google Cloud Storageを選択します。
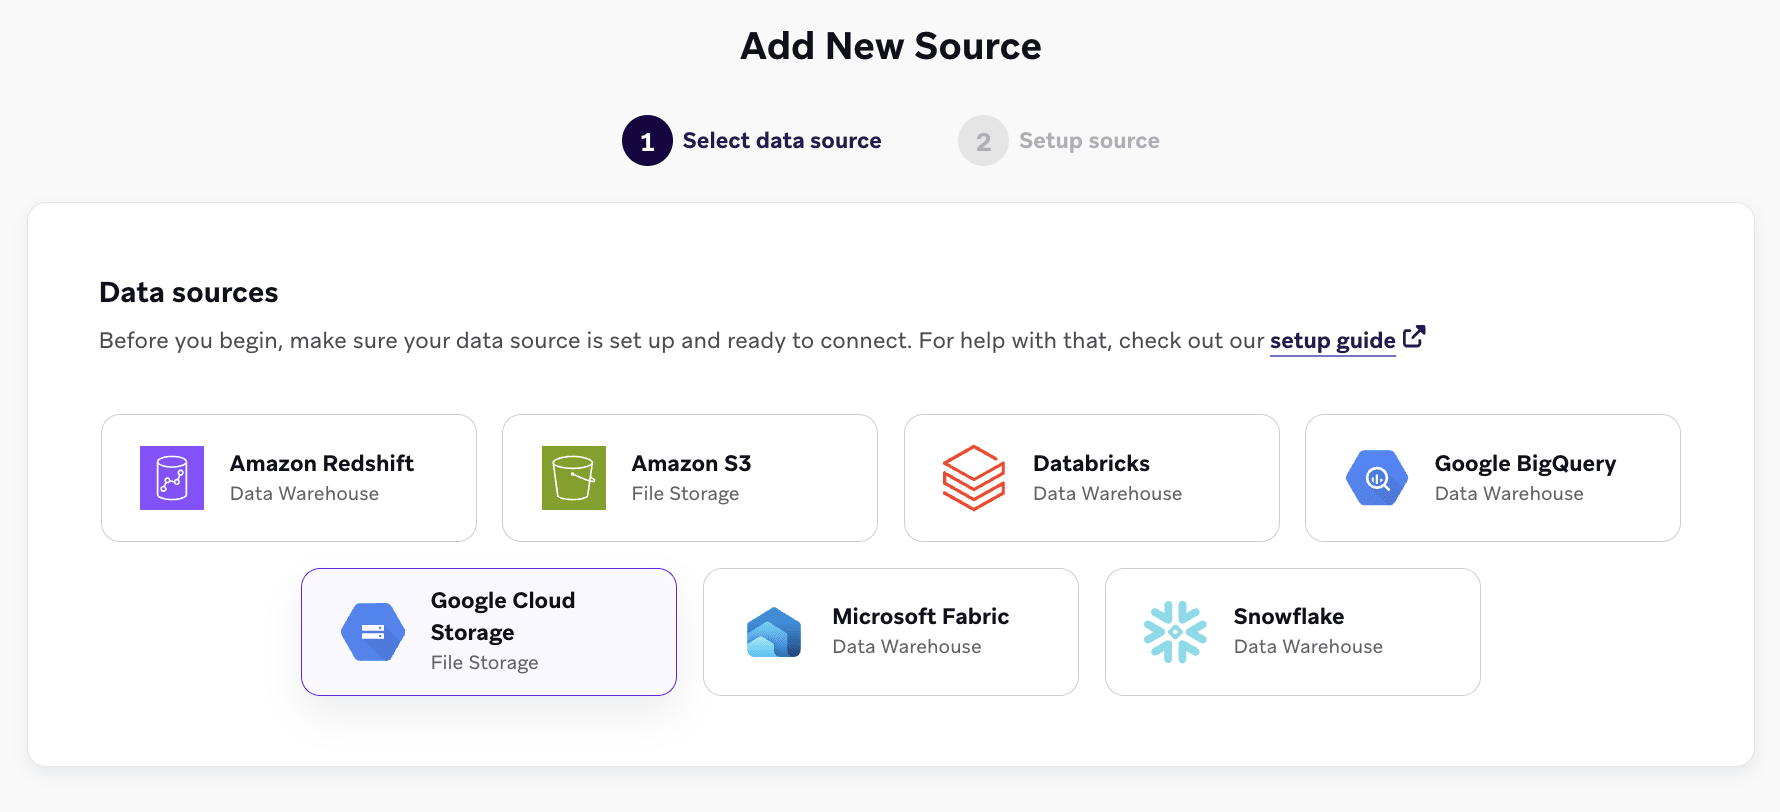
- ソースのフィールドに入力します。
- Bucket: バケット名
- Project ID: GCPプロジェクトID
- Service account JSON key: ステップ6のキーファイルをアップロードし、認証情報に名前を付けます
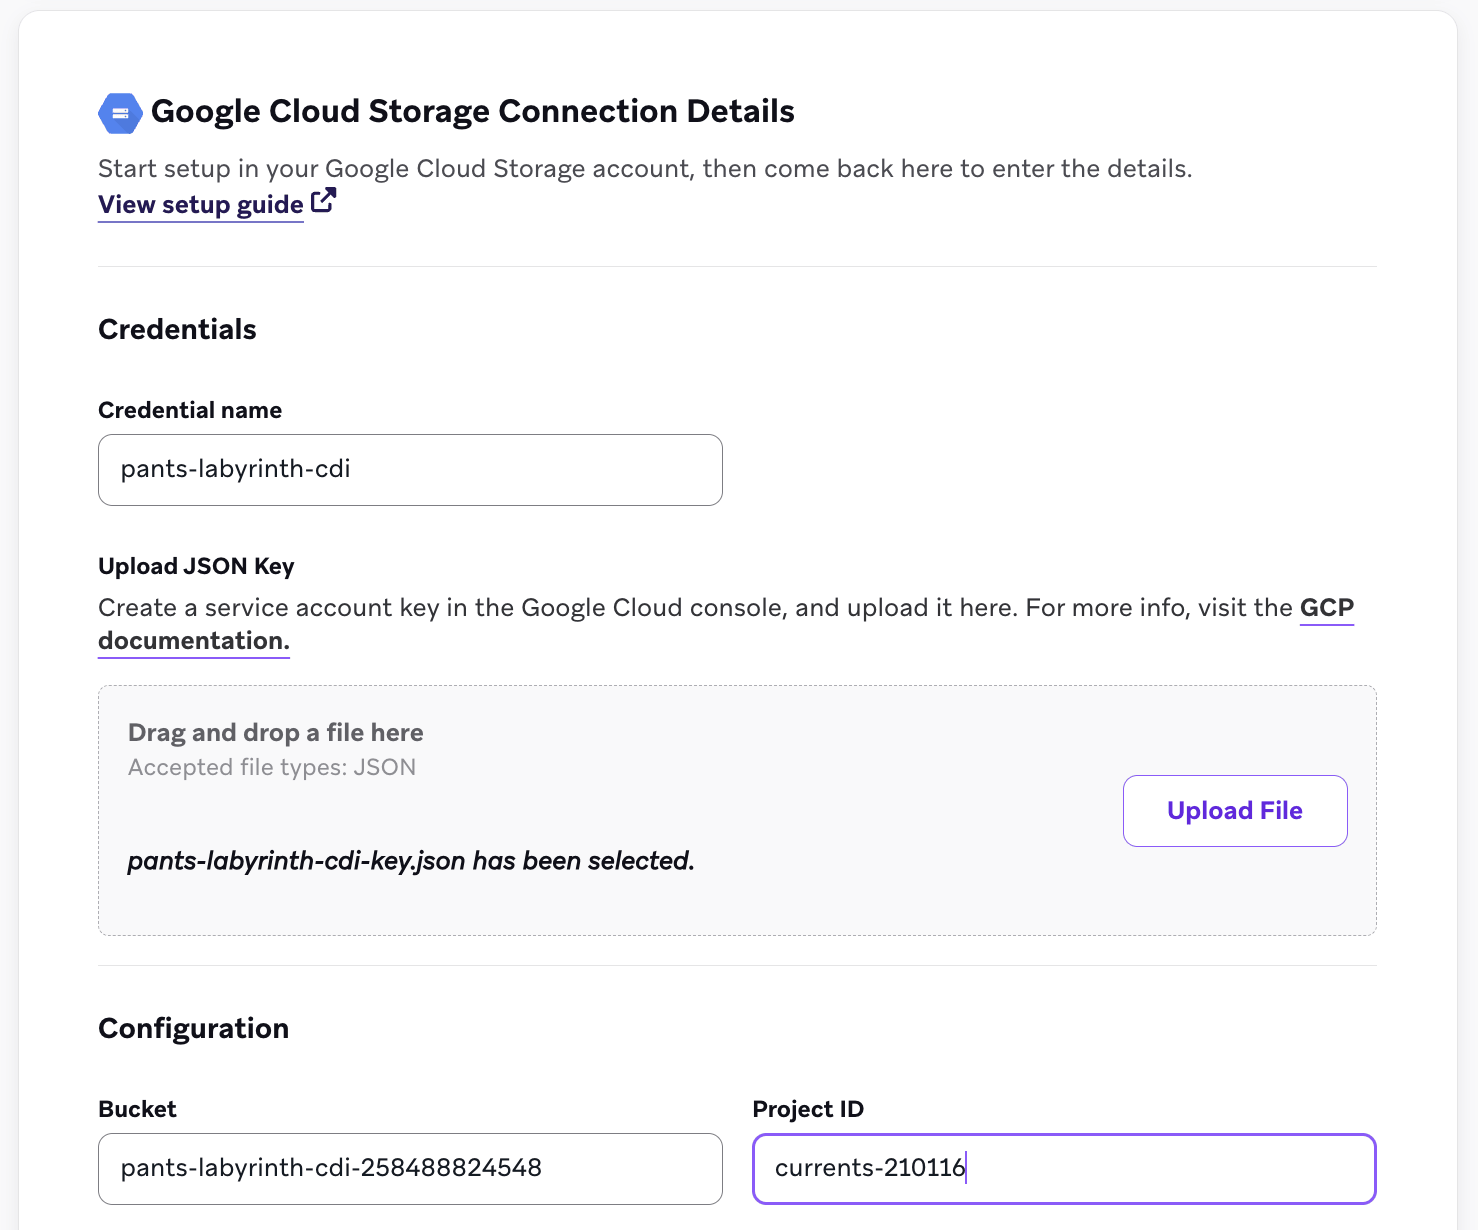
- Test connectionを選択してから、Connect to Sourceを選択します。
- 同期を作成します。Data Settings > Cloud Data Ingestion > Syncsに移動し、Create data syncを選択します。同期名とData Type(User Attributes、Custom Events、Purchase Events、Catalog、Delete Usersなど)を選択してから、Nextを選択します。
- Data definitionステップで、GCSソースを選択してから以下を指定します。
- Pub/Sub subscription ID: ステップ2のサブスクリプションID(トピックではありません)
- Folder path(オプション): バケット内のパスプレフィックス(共有バケット内のフォルダを同期するを参照)
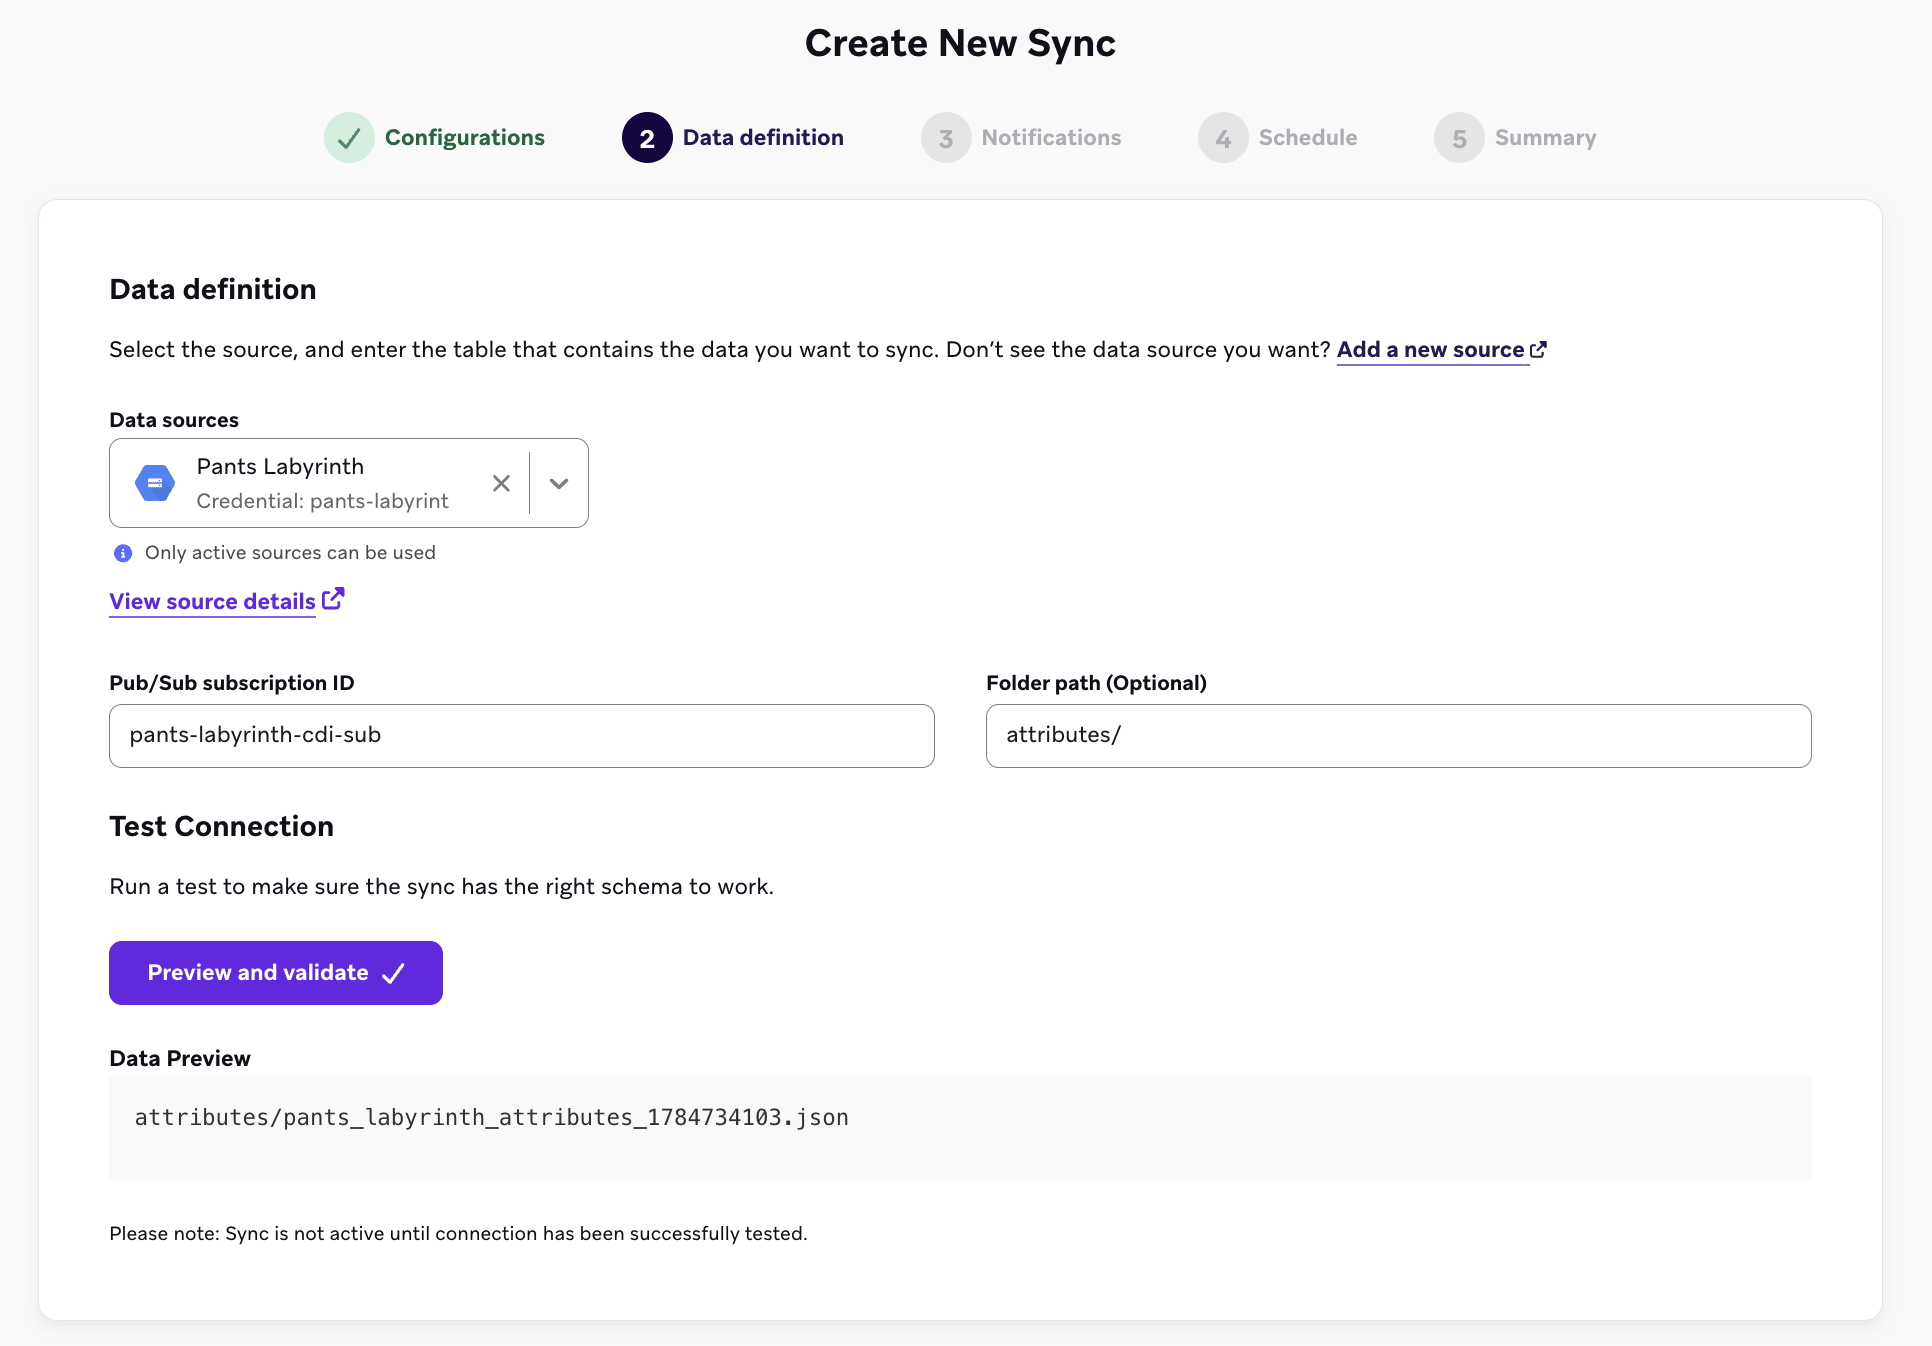
- Preview and validateを選択して、Brazeがサブスクリプションに到達し、取り込み可能なファイルを一覧表示できることを確認します。テストが成功するとバケット内の既存ファイルが表示されますが、それらのファイルは自動的に同期されません。
- エラー通知用の連絡先メールアドレスを追加します。Google Cloud Storageの同期はイベント駆動型のため、スケジュールは不要です。Brazeはファイルがアップロードされると新しいファイルを取り込みます。概要を確認し、Create syncを選択します。
共有バケット内のフォルダを同期する
1つのバケットを複数の同期で再利用できますが、各同期は個別のフォルダかつ専用のPub/Subサブスクリプションをターゲットにする必要があります。
同じソースバケットを共有する複数の同期では、フォルダパスとサブスクリプションはワークスペース内の同期間で両方とも一意である必要があります。ステップ2と同様に、これらのサブスクリプションにデッドレターキューを設定しないでください。
共有バケット内で同期したい各フォルダについて:
- 同期のFolderフィールドをパスプレフィックスに設定します(例:
attributes/)。Brazeはそのプレフィックスで始まるパスのオブジェクトのみを一覧表示し、取り込みます。 -
そのフォルダの専用トピックとプレフィックススコープの通知を作成してから、そのトピックにサブスクリプションを作成します。
# フォルダごとに1つのトピック gcloud pubsub topics create YOUR-ATTRIBUTES-TOPIC --project=YOUR-PROJECT-ID # Cloud Storageサービスエージェントにトピックへのパブリッシャー権限を割り当て gcloud pubsub topics add-iam-policy-binding YOUR-ATTRIBUTES-TOPIC \ --project=YOUR-PROJECT-ID \ --member="serviceAccount:service-YOUR-PROJECT-NUMBER@gs-project-accounts.iam.gserviceaccount.com" \ --role="roles/pubsub.publisher" # --object-prefixでフォルダにスコープされた通知 gcloud storage buckets notifications create gs://YOUR-BUCKET-NAME \ --topic=YOUR-ATTRIBUTES-TOPIC --event-types=OBJECT_FINALIZE \ --payload-format=json --object-prefix=attributes/ # 同期ごとに1つのサブスクリプション gcloud pubsub subscriptions create YOUR-ATTRIBUTES-SUBSCRIPTION \ --topic=YOUR-ATTRIBUTES-TOPIC --project=YOUR-PROJECT-ID --ack-deadline=60
-
ステップ5と同様に、Brazeサービスアカウントにそのサブスクリプションのコンシューム権限を割り当てます。
gcloud pubsub subscriptions add-iam-policy-binding YOUR-ATTRIBUTES-SUBSCRIPTION \ --project=YOUR-PROJECT-ID \ --member="serviceAccount:braze-cdi-gcs@YOUR-PROJECT-ID.iam.gserviceaccount.com" \ --role="roles/pubsub.subscriber"
ステップ5でカスタムロールを作成した場合は、代わりに
--role="projects/YOUR-PROJECT-ID/roles/brazeCdiGcs"を使用してください。 - Brazeで同期を作成する際、このフォルダの新しいPub/Sub subscription IDとFolder pathを入力して、同期がそのフォルダのファイルのみを取り込むようにします。
この連携には以下のリソースが必要です。
- データストレージ用のBlobコンテナを持つストレージアカウント
- 新しいファイル通知用のAzure StorageキューとイベントサブスクリプションF
- CDIがコンテナとキューを読み取るために使用するMicrosoft Entra IDサービスプリンシパル
Azureの定義
| 用語 | 定義 |
|---|---|
| ストレージアカウント | ストレージアカウントは、CDIがファイルを読み取るコンテナとCDIが通知を読み取るキューの両方を保持するトップレベルのAzureリソースです。 |
| コンテナ | コンテナは、CDIに取り込むデータファイルを保持します。コンテナはストレージアカウント内に存在します。 |
| Azure Storageキュー | キューは、コンテナからの新しいファイル通知を受け取ります。CDIはこのキューからメッセージを読み取り、確認して、どのファイルを取り込むかを判断します。 |
| イベントサブスクリプション | イベントサブスクリプションは、Azure Event Gridサービスを使用して、ストレージアカウントから送信先にイベントをルーティングします。Blob Createdイベントをキューに送信するように設定します。 |
| システムトピック | システムトピックはイベントのソースを表します。最初のイベントサブスクリプションを追加すると、Event Gridがストレージアカウント用に1つ作成します。 |
| サービスプリンシパル | サービスプリンシパルは、CDIが認証に使用するMicrosoft Entra ID IDです。アプリ登録を通じて作成し、その認証情報をBrazeに入力します。 |
| Azureロール割り当て | ロール割り当ては、特定のスコープでサービスプリンシパルに一連の権限を付与します。Brazeサービスプリンシパルに2つの組み込みロールをストレージアカウントで割り当てます。 |
Azureでのクラウドデータ取り込みの設定
ステップ1:コンテナを作成する
コンテナとキューは同じストレージアカウント内に存在する必要があります。既存のストレージアカウントを再利用できます。まだ持っていない場合は、AzureポータルでStorage accounts > + Createに移動して作成します。
- Azureポータルでストレージアカウントに移動し、Data storage > Containersに移動します。
- + Add containerを選択し、名前を付けます。
ストレージアカウント名とコンテナ名をメモしてください。Brazeでソースを設定する際に両方が必要になります。
ステップ2:キューを作成する
- 同じストレージアカウントで、Data storage > Queuesに移動します。
- + Queueを選択し、名前を付けます。
キュー名をメモしてください。同期を作成する際に必要になり、各同期には専用のキューが必要です。
ステップ3:イベントサブスクリプションを作成する
ファイルが到着するたびにコンテナがキューに通知するように、イベントサブスクリプションを作成します。
- 同じストレージアカウントで、Eventsに移動してから、+ Event Subscriptionを選択します。
- Event Subscription Detailsで、Nameを入力し、Event SchemaをEvent Grid Schemaに設定します。
- Topic Detailsで、System Topic Nameを確認します。ストレージアカウントにまだシステムトピックがない場合は、名前を入力して作成します。すでにある場合は、フィールドにその名前が表示され、変更できません。ストレージアカウントのすべてのイベントサブスクリプションは同じシステムトピックを使用します。
- Event Typesで、Filter to Event TypesをBlob Createdのみに設定します。Blob Deletedもデフォルトで選択されているため、クリアしてください。
- Endpoint Detailsで、Endpoint TypeをStorage Queueに設定します。エンドポイントタイプを選択すると、Configure an endpointリンクが表示されます。
- Configure an endpointを選択し、使用しているストレージアカウントを選択します。
- Select existing queueを選択し、ステップ2で作成したキューを選択します。
- Selectを選択してエンドポイントを確認します。
- Createを選択します。
ステップ4:サービスプリンシパルを作成する
CDIは、Microsoft Entra ID認証を使用するサービスプリンシパルでストレージアカウントに接続します。Brazeが接続するために必要な情報は以下のとおりです。
- AzureアカウントのテナントID(ディレクトリとも呼ばれます)
- サービスプリンシパルのプリンシパルID(アプリケーションIDとも呼ばれます)
- Brazeが認証に使用するクライアントシークレット
アプリケーションの登録には、Microsoft Entra IDでアプリ登録を作成する権限が必要です。権限がない場合は、Entra管理者にこのステップを完了してもらい、認証情報を共有するよう依頼してください。
- Azureポータルで、Microsoft Entra管理センターに移動し、App Registrationsを選択します。
- Identity > Applications > App registrationsの下にある+ New registrationを選択します。
- 名前を入力し、サポートされるアカウントの種類として
Accounts in this organizational directory onlyを選択します。次に、Registerを選択します。 - 作成したアプリケーション(サービスプリンシパル)を選択し、Certificates & secrets > + New client secretに移動します。
- シークレットの説明を入力し、シークレットの有効期限を設定します。次に、Addを選択します。
- 作成されたクライアントシークレットをメモしておき、Brazeの設定で使用します。
Azureではサービスプリンシパルのシークレットに無期限の有効期限を設定できません。Brazeへのデータフローを維持するために、認証情報が期限切れになる前に更新することを忘れないでください。
CDI専用のサービスプリンシパルを作成することをお勧めします。これにより、同期するコンテナとキューへのアクセスに限定されます。Microsoft Fabricソース用にすでに設定済みのサービスプリンシパルがある場合は再利用できますが、その場合両方にアクセスできるようになります。いずれの場合も、次のステップでロール割り当てが必要です。
ステップ5:サービスプリンシパルに権限を割り当てる
CDIに必要なのは、ファイルを読み取り、キューメッセージを処理するのに十分なアクセスのみです。これらの2つの組み込みロールをストレージアカウント自体に割り当てます。サブスクリプションやリソースグループではなく、ロール割り当ては下位に継承されるためです。CDIが使用しない書き込みおよび管理権限を付与するStorage Blob Data Contributor、Storage Account Contributor、Ownerなどのより広いロールは割り当てないでください。
- ストレージアカウントに移動し、Access Control (IAM)に移動します。
- Add > Add role assignmentを選択します。
- ステップ4で作成したサービスプリンシパルを名前で検索します。
- 以下の組み込みロールを割り当てます。
- Storage Blob Data Reader: CDIがコンテナ内のファイルを読み取れるようにします。
- Storage Queue Data Message Processor: CDIがキューのメッセージをピーク、取得、削除できるようにします。
カスタムロールを使用することもできますが、コンテナ内のBlobへの読み取りアクセスとキューのメッセージの受信および削除が可能な権限のみを付与するようにしてください。
Add role assignmentがグレーアウトしている場合、アカウントにこのストレージアカウントでロールを割り当てる権限がありません。これにはOwnerまたはUser Access Administratorなどのロールが必要です。Azure管理者にこのステップを完了するよう依頼してください。
Brazeでのクラウドデータ取り込みの設定
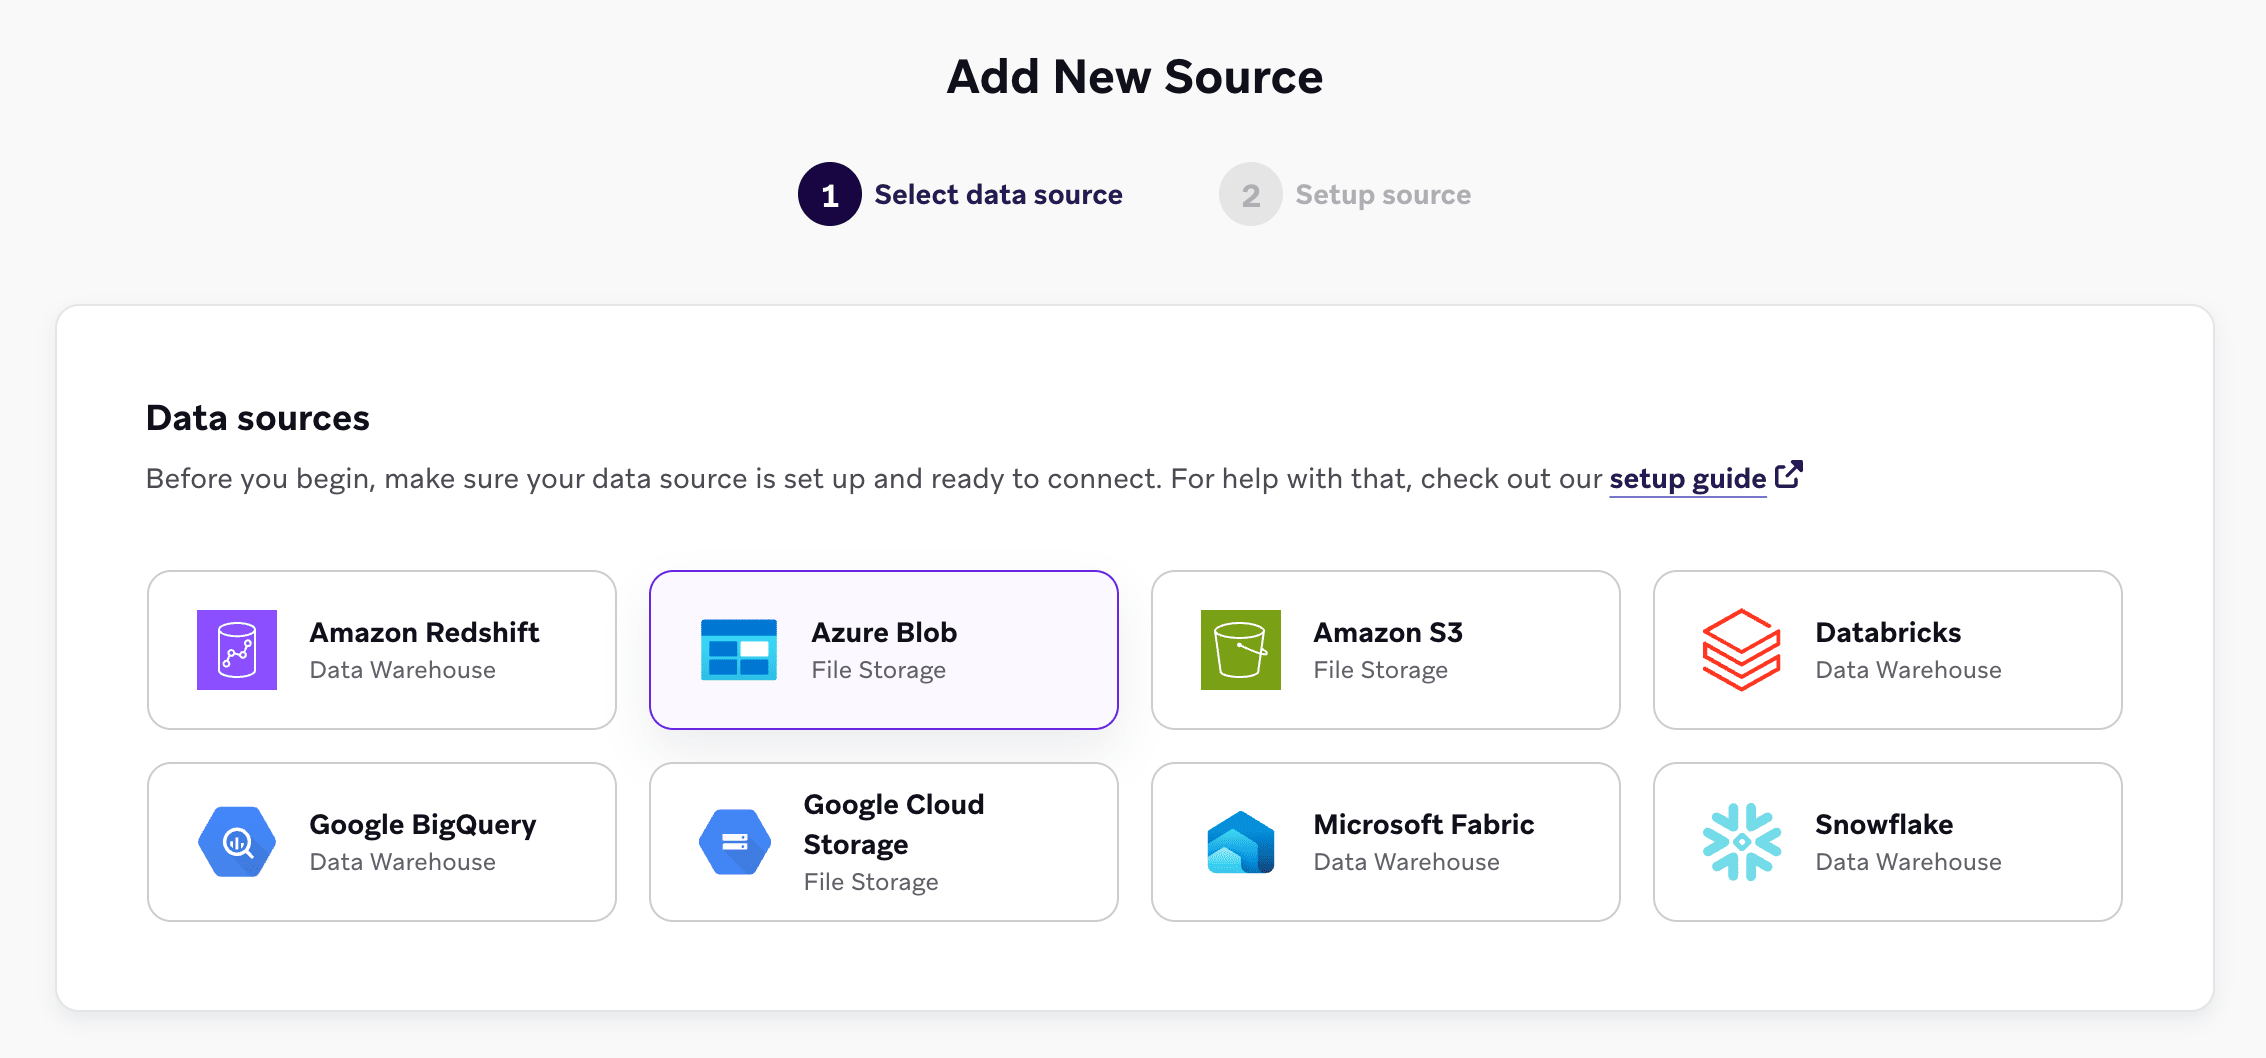
- Brazeで、Data Settings > Cloud Data Ingestion > Sourcesに移動し、Add data sourceを選択してから、Azure Blobを選択します。
- Azure Blob Connection Detailsのフィールドに入力します。
- Credentials: Tenant ID、Principal ID、Client Secret
- Configuration: Storage accountとContainer
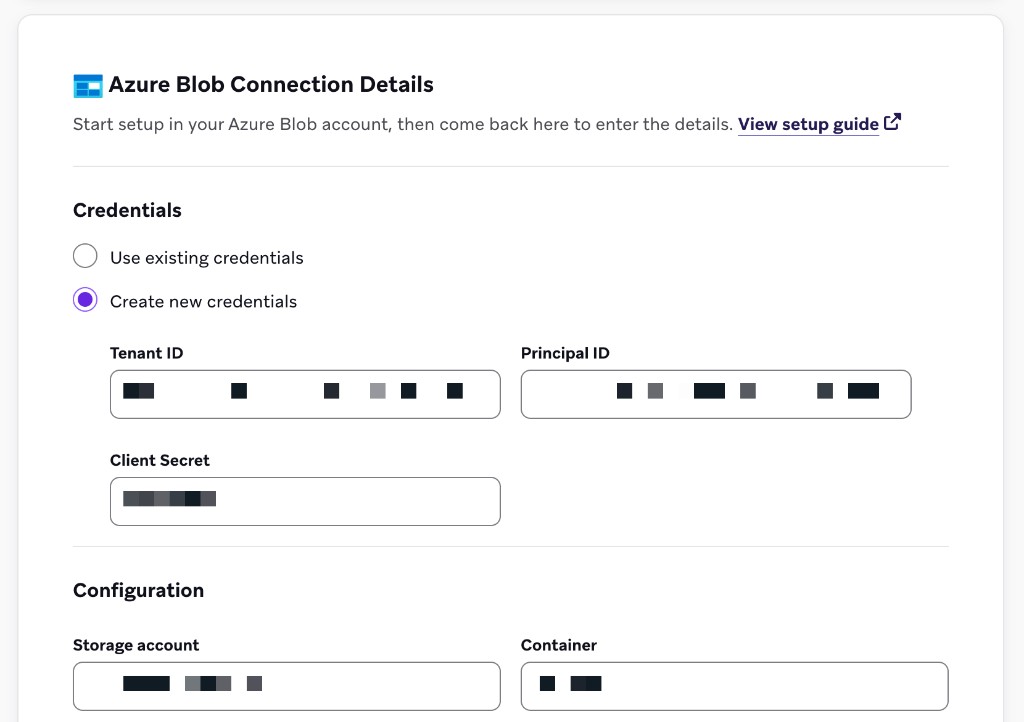
- Test connectionを選択してから、Connect to Sourceを選択します。
- 同期を作成します。Data Settings > Cloud Data Ingestion > Syncsに移動し、Create data syncを選択します。
- Configurationsで、同期名を選択し、Azure Blobソースを選択してから、Data Type(User Attributes、Custom Events、Purchase Events、Catalog、Delete Usersなど)を選択します。
- Data definitionで、以下を指定します。
- Storage queue name: ステップ2で作成したキュー。各同期には専用のキューが必要です(共有コンテナ内のフォルダを同期するを参照)。
- Folder path (Optional): コンテナ内のパスプレフィックス
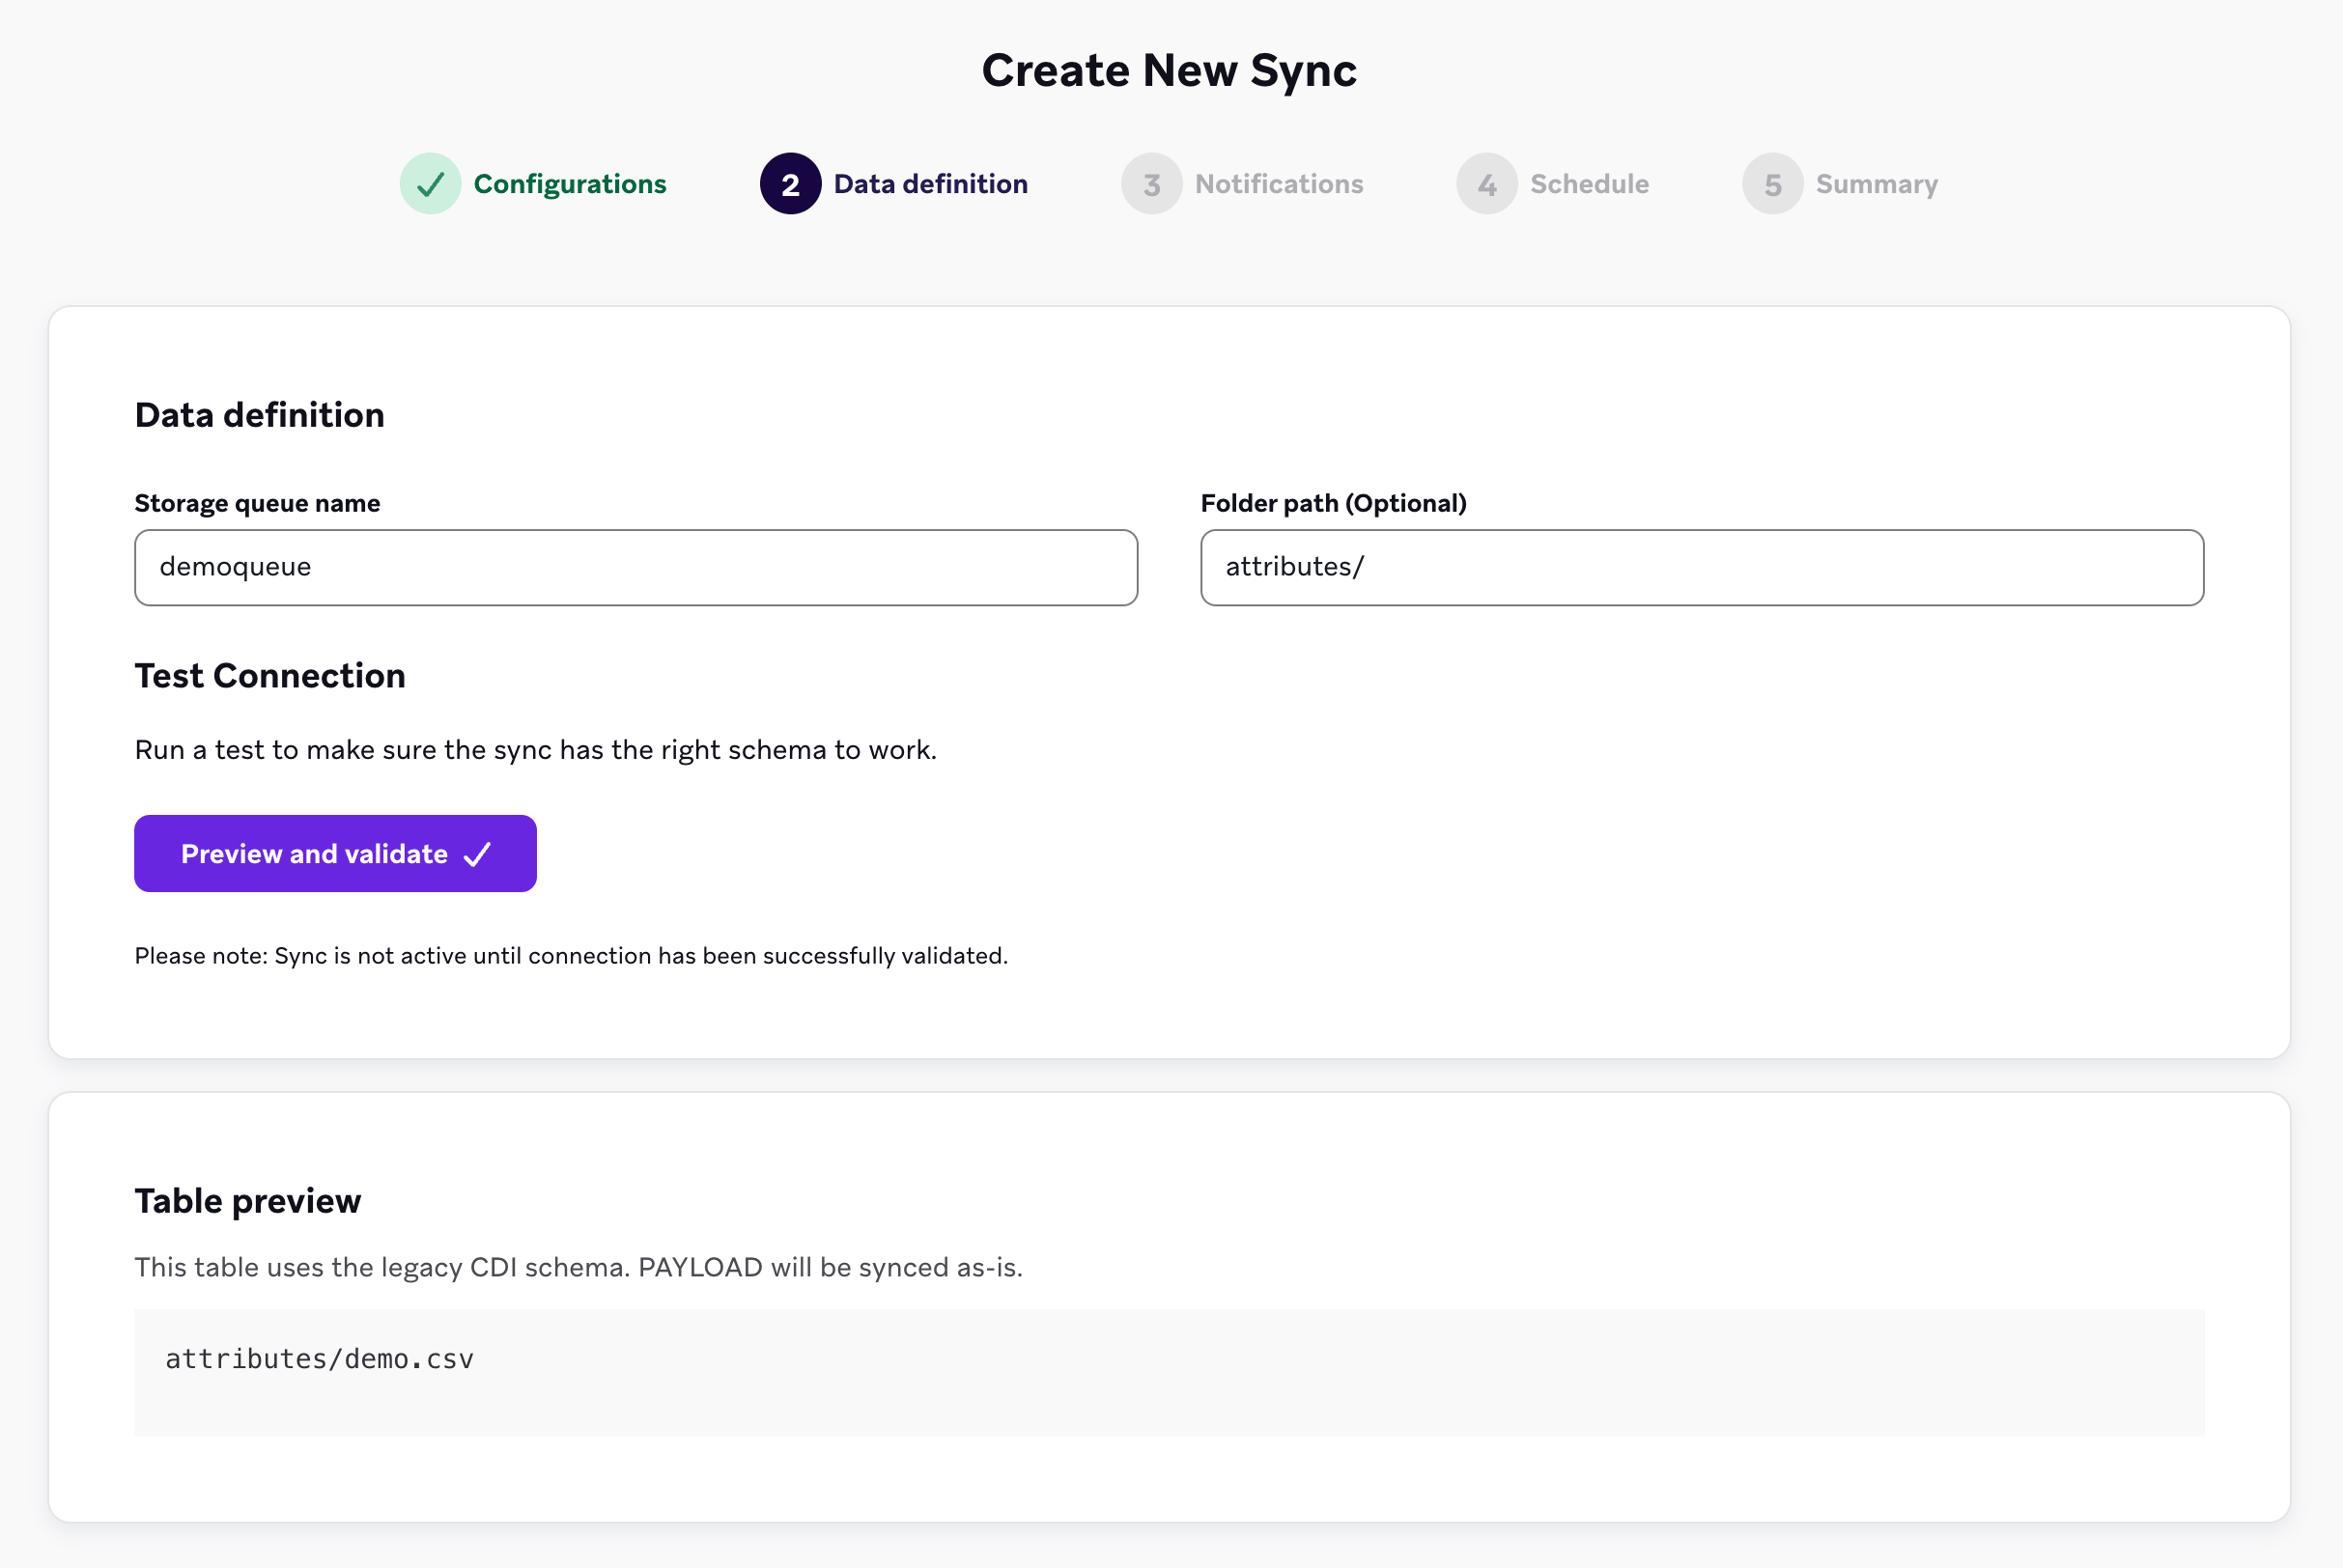
- Preview and validateを選択して、CDIがキューに到達し、取り込み可能なファイルを一覧表示できることを確認します。テストが成功するとコンテナ内の既存ファイルが表示されますが、それらのファイルは自動的に同期されません。接続の検証が成功するまで同期はアクティブになりません。
- Notificationsで、エラー通知用の連絡先メールアドレスを追加します。
- Scheduleには、ファイルストレージ同期用のオプションはありません。Azure Blob Storageの同期はイベント駆動型のため、CDIはファイルがアップロードされると新しいファイルを取り込みます。
- Summaryを確認してから、Create syncを選択します。
共有コンテナ内のフォルダを同期する
1つのコンテナを複数の同期で再利用できますが、各同期には専用のストレージキューと専用のフォルダが必要です。
2つの同期が同じストレージキューを使用することはできません。別の同期がすでに使用しているキューを入力すると、CDIがフラグを立て、既存の同期にリンクします。
共有コンテナ内で同期したい各フォルダについて:
必須のファイル形式
必須のファイル形式は、Amazon S3、Google Cloud Storage、Azure Blob Storageで共通です。クラウドデータ取り込みは、JSON、CSV、Parquetファイルをサポートしています。必須カラムはデータタイプによって異なります。
- ユーザーデータ(属性、カスタムイベント、購入イベント)はユーザー識別子とペイロードを使用します
- カタログデータはカタログ識別子を使用します
ファイルストレージをカタログデータに使用する場合、カタログ固有の要件と動作については、このページとカタログデータの同期と削除を合わせてご覧ください。
Brazeは、ファイルストレージプロバイダーが求める以上のファイル名要件を設けていません。ファイル名は一意である必要があります。タイムスタンプを付加することで一意性を確保できます。
サポートされているすべてのファイルタイプ(属性、カスタムイベント、購入、カタログ、ユーザー削除)の例については、braze-examplesのサンプルファイルを参照してください。
ユーザー識別子
ユーザーデータの同期(属性、カスタムイベント、購入イベント)では、ソースファイルの各行にユーザー識別子が1つとPAYLOADカラムが必要です。ソースファイルには異なる識別子タイプの行を含めることができますが、各行には1つの識別子のみを使用してください。
| 識別子 | 説明 |
|---|---|
EXTERNAL_ID |
更新対象のユーザーを識別します。Brazeで使用されるexternal_idの値と一致させる必要があります。 |
ALIAS_NAMEとALIAS_LABEL |
この2つのカラムでユーザーエイリアスオブジェクトを作成します。alias_nameは一意の識別子で、alias_labelはエイリアスの種類を指定します。ユーザーは異なるラベルで複数のエイリアスを持つことができますが、alias_labelごとにalias_nameは1つだけです。 |
BRAZE_ID |
Brazeユーザー識別子です。Braze SDKによって生成され、クラウドデータ取り込みを通じてBraze IDで新しいユーザーを作成することはできません。新しいユーザーを作成するには、external IDまたはユーザーエイリアスを指定してください。 |
EMAIL |
ユーザーのメールアドレスです。同じメールアドレスを持つプロファイルが複数存在する場合、最も最近更新されたプロファイルが優先されます。メールと電話番号の両方を含める場合、Brazeはメールをプライマリ識別子として使用します。 |
PHONE |
ユーザーの電話番号です。同じ電話番号を持つプロファイルが複数存在する場合、最も最近更新されたプロファイルが優先されます。 |
識別子に加えて、各行にはBrazeのユーザーに同期するフィールドのJSON文字列を含むPAYLOADカラムが必要です。
データウェアハウスソースとは異なり、UPDATED_ATカラムはファイルストレージの同期では不要であり、サポートもされていません。
カタログ識別子
カタログの同期では、ソースファイルに以下のカラムを含める必要があります。カタログファイルはユーザーデータファイルとは異なる識別子を使用します。
| カラム | 必須 | 説明 |
|---|---|---|
ID |
はい | カタログアイテムの一意の識別子です。Brazeでアイテムの作成、更新、削除に使用されます。 |
PAYLOAD |
はい | 同期するカタログフィールドと値のJSON文字列です。Brazeのカタログスキーマと一致させる必要があります。 |
DELETED |
いいえ | trueの場合、一致するIDのカタログアイテムがBrazeのカタログから削除されます。作成または更新操作の場合は、このカラムを省略するかfalseに設定してください。 |
例
{"external_id":"s3-qa-0","payload":"{\"name\": \"GT896\", \"age\": 74, \"subscriber\": true, \"retention\": {\"previous_purchases\": 21, \"vip\": false}, \"last_visit\": \"2023-08-08T16:03:26.600803\"}"}
{"external_id":"s3-qa-1","payload":"{\"name\": \"HSCJC\", \"age\": 86, \"subscriber\": false, \"retention\": {\"previous_purchases\": 0, \"vip\": false}, \"last_visit\": \"2023-08-08T16:03:26.600824\"}"}
{"external_id":"s3-qa-2","payload":"{\"name\": \"YTMQZ\", \"age\": 43, \"subscriber\": false, \"retention\": {\"previous_purchases\": 23, \"vip\": true}, \"last_visit\": \"2023-08-08T16:03:26.600831\"}"}
{"external_id":"s3-qa-3","payload":"{\"name\": \"5P44M\", \"age\": 15, \"subscriber\": true, \"retention\": {\"previous_purchases\": 7, \"vip\": true}, \"last_visit\": \"2023-08-08T16:03:26.600838\"}"}
{"external_id":"s3-qa-4","payload":"{\"name\": \"WMYS7\", \"age\": 11, \"subscriber\": true, \"retention\": {\"previous_purchases\": 0, \"vip\": false}, \"last_visit\": \"2023-08-08T16:03:26.600844\"}"}
{"external_id":"s3-qa-5","payload":"{\"name\": \"KCBLK\", \"age\": 47, \"subscriber\": true, \"retention\": {\"previous_purchases\": 11, \"vip\": true}, \"last_visit\": \"2023-08-08T16:03:26.600850\"}"}
{"external_id":"s3-qa-6","payload":"{\"name\": \"T93MJ\", \"age\": 47, \"subscriber\": true, \"retention\": {\"previous_purchases\": 10, \"vip\": false}, \"last_visit\": \"2023-08-08T16:03:26.600856\"}"}
ソースファイルのすべての行に有効なJSONが含まれている必要があります。含まれていない場合、そのファイルはスキップされます。
{"external_id":"s3-qa-0","payload":"{\"app_id\": \"YOUR_APP_ID\", \"name\": \"view-206\", \"time\": \"2024-04-02T14:34:08\", \"properties\": {\"bool_value\": false, \"preceding_event\": \"unsubscribe\", \"important_number\": 206}}"}
{"external_id":"s3-qa-1","payload":"{\"app_id\": \"YOUR_APP_ID\", \"name\": \"view-206\", \"time\": \"2024-04-02T14:34:08\", \"properties\": {\"bool_value\": false, \"preceding_event\": \"unsubscribe\", \"important_number\": 206}}"}
ソースファイルのすべての行に有効なJSONが含まれている必要があります。含まれていない場合、そのファイルはスキップされます。
{"external_id":"s3-qa-0","payload":"{\"app_id\": \"YOUR_APP_ID\", \"product_id\": \"product-11\", \"currency\": \"BSD\", \"price\": 8.511527858335066, \"time\": \"2024-04-02T14:34:08\", \"quantity\": 19, \"properties\": {\"is_a_boolean\": true, \"important_number\": 40, \"preceding_event\": \"click\"}}"}
{"external_id":"s3-qa-1","payload":"{\"app_id\": \"YOUR_APP_ID\", \"product_id\": \"product-11\", \"currency\": \"BSD\", \"price\": 8.511527858335066, \"time\": \"2024-04-02T14:34:08\", \"quantity\": 19, \"properties\": {\"is_a_boolean\": true, \"important_number\": 40, \"preceding_event\": \"click\"}}"}
ソースファイルのすべての行に有効なJSONが含まれている必要があります。含まれていない場合、そのファイルはスキップされます。
external_id,payload
s3-qa-load-0-d0daa196-cdf5-4a69-84ae-4797303aee75,"{""name"": ""SNXIM"", ""age"": 54, ""subscriber"": true, ""retention"": {""previous_purchases"": 19, ""vip"": true}, ""last_visit"": ""2023-08-08T16:03:26.598806""}"
s3-qa-load-1-d0daa196-cdf5-4a69-84ae-4797303aee75,"{""name"": ""0J747"", ""age"": 73, ""subscriber"": false, ""retention"": {""previous_purchases"": 22, ""vip"": false}, ""last_visit"": ""2023-08-08T16:03:26.598816""}"
s3-qa-load-2-d0daa196-cdf5-4a69-84ae-4797303aee75,"{""name"": ""EP1U0"", ""age"": 99, ""subscriber"": false, ""retention"": {""previous_purchases"": 23, ""vip"": false}, ""last_visit"": ""2023-08-08T16:03:26.598822""}"
ID,PAYLOAD,DELETED
85,"{""product_name"": ""Product 85"", ""price"": 85.85}",false
1,"{""product_name"": ""Product 1"", ""price"": 1.01}",true
オプションのDELETEDカラムを含めることができます。DELETEDがtrueの場合、そのカタログアイテムはBrazeのカタログから削除されます。必須カラムの完全なリストについては、カタログ識別子を参照してください。削除の動作については、カタログアイテムの削除を参照してください。エンドツーエンドのカタログ設定フロー(対象カタログの作成と同期の動作を含む)については、カタログデータの同期と削除を参照してください。
データの削除
ファイルストレージ向けのCloud Data Ingestionは、ファイルアップロードによるユーザーおよびカタログアイテムの削除をサポートしています。それぞれに個別の同期とファイル形式を使用してください。
- ユーザーの削除 – データタイプをDelete Usersに設定した同期を作成し、ユーザー識別子のみを含むファイル(ペイロードなし)をアップロードします。
- カタログアイテムの削除 – 既存のカタログ同期を使用し、
deleted(またはDELETED)列を追加して削除対象のアイテムをマークします。
ユーザーの削除
ソースバケット内のファイルを使用してBrazeのユーザープロファイルを削除するには:
- 新しいCloud Data Ingestion同期を作成します(他の同期と同じ設定方法です)。
- Brazeで同期を設定する際、Data TypeをDelete Usersに設定します。
- ユーザー識別子列のみを含むファイルをソースバケットにアップロードします。
PAYLOAD列は含めないでください。誤削除を防ぐため、ペイロードが存在すると同期は失敗します。
ファイルの各行は、以下のいずれかを使用して正確に1人のユーザーを識別する必要があります。
| 識別子 | 説明 |
|---|---|
EXTERNAL_ID |
Brazeで使用されるexternal_idと一致します。 |
ALIAS_NAMEとALIAS_LABEL |
両方の列を組み合わせてエイリアスでユーザーを識別します。 |
BRAZE_ID |
Brazeが生成したユーザーID(既存ユーザーのみ)。 |
ユーザーの削除は永続的であり、元に戻すことはできません。削除する意図のあるユーザーのみを含めてください。詳細については、Cloud Data Ingestionでユーザーを削除するを参照してください。
例 – JSON(ユーザー削除):
{"external_id":"user-to-delete-001"}
{"external_id":"user-to-delete-002"}
{"braze_id":"braze-id-from-profile"}
例 – CSV(ユーザー削除):
external_id
user-to-delete-001
user-to-delete-002
同期が実行されると、Brazeはバケット内の新しいファイルを処理し、対応するユーザープロファイルを削除します。
カタログアイテムの削除
ファイルストレージを使用してカタログからアイテムを削除するには:
- カタログデータの同期に使用しているものと同じ同期(データタイプCatalogs)を使用します。
- CSVまたはJSONファイルに、オプションの
deleted(またはDELETED)列を追加します。 - Brazeのカタログから削除したいカタログアイテムの
deletedをtrueに設定します。
各行には引き続きIDとPAYLOADが必要です。削除対象としてマークされた行では、ペイロードは最小限で構いません。BrazeはIDに基づいてアイテムを削除します。
例 – JSON(カタログアイテムの削除):
{"id":"85","payload":"{\"product_name\": \"Product 85\", \"price\": 85.85}"}
{"id":"1","payload":"{\"product_name\": \"Product 1\", \"price\": 1.01}","deleted":true}
例 – CSV(カタログアイテムの削除):
ID,PAYLOAD,DELETED
85,"{""product_name"": ""Product 85"", ""price"": 85.85}",false
1,"{""product_name"": ""Product 1"", ""price"": 1.01}",true
同期が実行されると、deleted: trueの行は、Brazeで一致するカタログアイテムを削除します。カタログの同期と削除の動作の詳細については、カタログデータの同期と削除を参照してください。
注意事項
- ソースバケットまたはコンテナに追加するファイルは512 MBを超えないようにしてください。この制限はAmazon S3、Google Cloud Storage、およびAzure Blob Storageに適用されます。512 MBを超えるファイルはエラーとなり、Brazeに同期されません。Azure Blob Storage自体はこれより大きなファイルに対応していますが、CDIはすべてのファイルストレージソースに同じ512 MBの制限を適用します。
- ファイルあたりの行数に追加の制限はありませんが、同期の実行速度を向上させるために、小さなファイルの使用をお勧めします。たとえば、500 MBのファイル1つを取り込むよりも、100 MBのファイル5つに分けた方がはるかに短時間で処理できます。
- 一定期間にアップロードできるファイル数に追加の制限はありません。
- ファイル内およびファイル間での順序付けはサポートされていません。予想される競合を監視している場合は、更新を定期的にバッチ処理することをお勧めします。
トラブルシューティング
ファイルのアップロードと処理
CDI は、同期が作成された後に追加されたファイルのみを処理します。このプロセスでは、Braze は新しいファイルの追加を検知し、新しい通知をトリガーします。これにより、新しいファイルを処理するための新しい同期が開始されます。Amazon S3 の場合、通知は SQS へのメッセージです。Google Cloud Storage の場合、Pub/Sub への OBJECT_FINALIZE メッセージです。Azure Blob Storage の場合、Azure Storage キューに配信される Blob Created イベントです。
既存のファイルを使用して、Braze がバケットにアクセスし、取り込むファイルを検出できることを検証できますが、それらのファイルは Braze に同期されません。CDI でこれらを処理するには、同期したい既存のファイルをソースバケットに再アップロードする必要があります。
予期しないファイルエラーの対処(Amazon S3)
多数のエラーまたは失敗したファイルが観測される場合、CDI のターゲットフォルダ以外のフォルダにある S3 バケットにファイルを追加する別のプロセスが存在している可能性があります。
ファイルがソースバケットにアップロードされたがソースフォルダ内にない場合、CDI は SQS 通知を処理しますが、そのファイルに対してアクションを実行しないため、エラーとして表示されることがあります。
問題が S3 通知または SQS 送信先の権限に関連している場合(たとえば、送信先の検証エラー)、AWS のドキュメントを参照してください。
予期しないファイルエラーの対処(Google Cloud Storage)
Amazon S3 と同様に、CDI は同期が作成された後にアップロードされたファイルのみを処理します。新しいオブジェクトごとに OBJECT_FINALIZE メッセージが Pub/Sub トピックにトリガーされます。バケットに既に存在するファイルを取り込むには、再アップロードしてください。
ファイルが取り込まれない場合は、以下を確認してください。
- バケット通知が存在すること。
gcloud storage buckets notifications list gs://YOUR-BUCKET-NAMEでバケットの通知を一覧表示できます。 - Cloud Storage サービスエージェントがトピックに対して
roles/pubsub.publisherを持っていること。 - Braze サービスアカウントがサブスクリプションに対する消費権限(
pubsub.subscriptions.consume、カスタムロールまたはroles/pubsub.subscriberで割り当て)を持っていること。 - サブスクリプションにデッドレターキューが設定されていないこと。Braze は Cloud Data Ingestion サブスクリプションのデッドレターキューをサポートしていません。
詳細については、Google Cloud ドキュメントの Cloud Storage の Pub/Sub 通知を参照してください。
予期しないファイルエラーの対処(Azure Blob Storage)
Amazon S3 および Google Cloud Storage と同様に、CDI は同期が作成された後にアップロードされたファイルのみを処理します。新しい blob ごとに Blob Created イベントがキューにトリガーされます。コンテナに既に存在するファイルを取り込むには、再アップロードしてください。
ファイルが取り込まれない場合は、以下を確認してください。
- ストレージアカウントにイベントサブスクリプションが存在し、Blob Created でフィルタリングされていること。
- イベントサブスクリプションが Event Grid Schema を使用していること。CDI は別のスキーマで配信されたイベントを読み取ることができません。
- イベントサブスクリプションのエンドポイントが、別のキューではなく、同期で設定されたキューを指していること。
- Braze サービスプリンシパルがストレージアカウントに対して Storage Blob Data Reader および Storage Queue Data Message Processor を持っていること。
- サービスプリンシパルのクライアントシークレットが期限切れになっていないこと。Azure はクライアントシークレットに有効期限を設定しており、期限切れのシークレットは同期を停止させます。
詳細については、Microsoft ドキュメントの Event Grid ソースとしての Azure Blob Storage を参照してください。